字节背后的棋局
数据锚点:2026-09-20。公开数据均标注来源方;标注「实测」「一手」的部分为个人使用与观察所得,非二手转述。
一封内部邮件
2026 年 7 月 30 日上午,一封内部邮件在字节跳动落地。
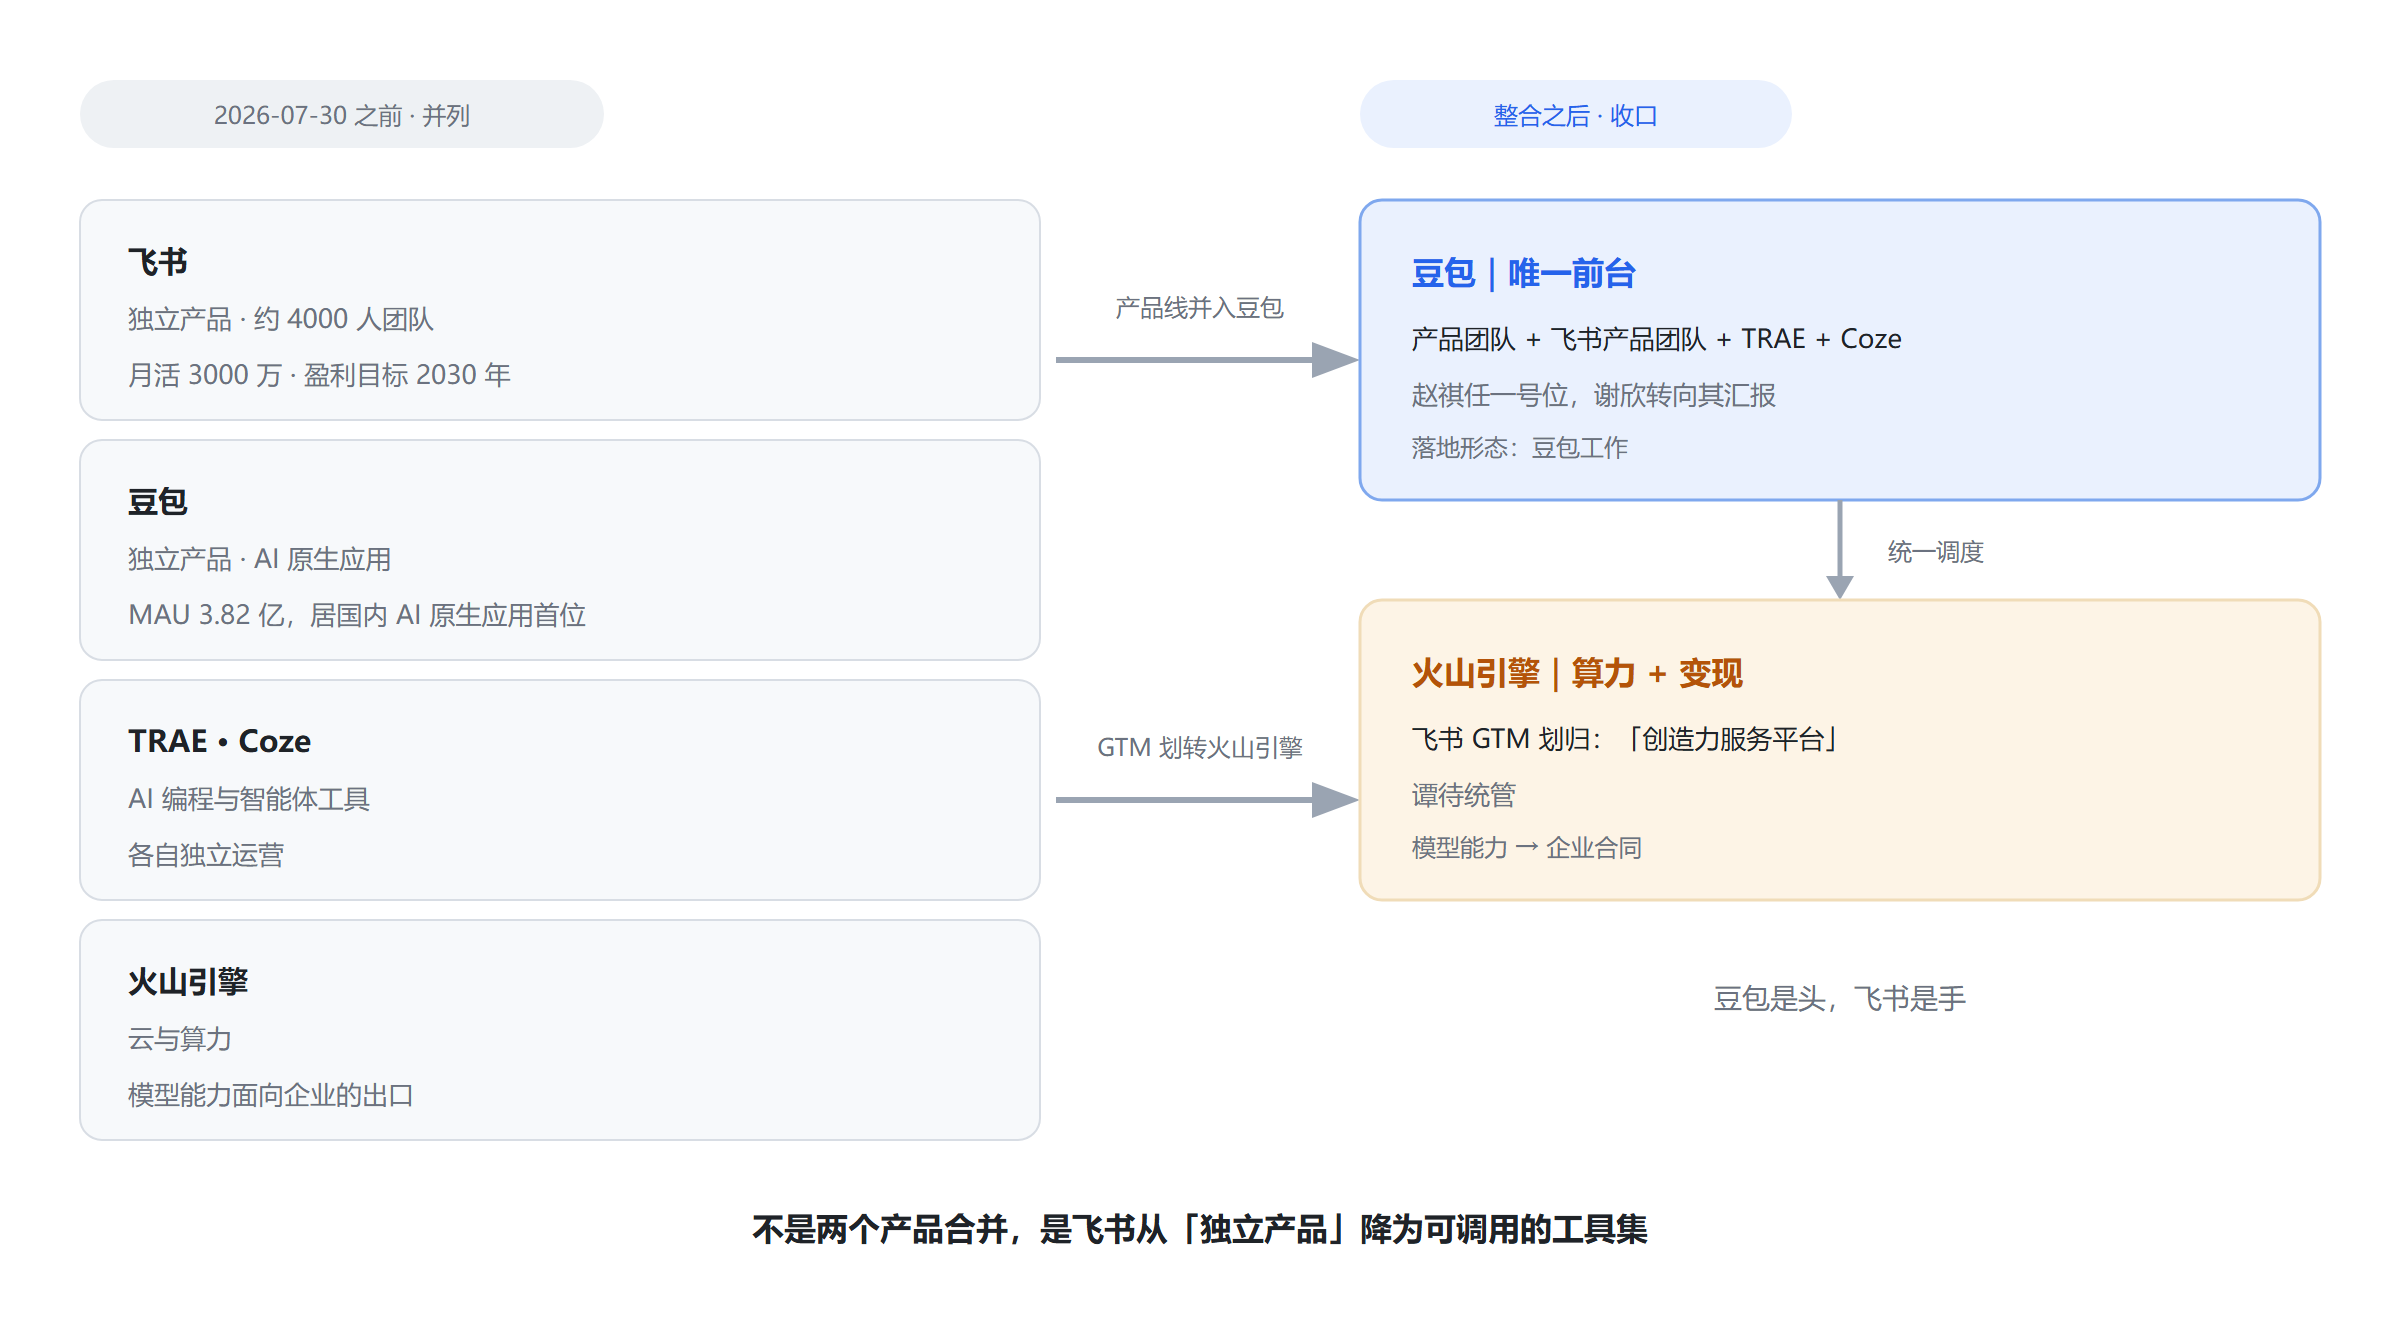
内容不长:飞书的产品团队整体并入豆包团队,成立新的豆包产品团队;豆包负责人赵祺成为一号位,飞书负责人谢欣转向他汇报。同一天,飞书的市场、销售与客服体系(GTM)划归火山引擎,组成一个名为「创造力服务平台」的新组织,由火山引擎负责人谭待统管。
谢欣加入字节十二年,带飞书带了十年。这一天之后,他不再向集团 CEO 直接汇报。
一个多月后的 9 月 15 日,「2026 飞书未来无限大会暨豆包工作开工大会」在北京举行。整合后的「豆包工作」首次亮相,飞书同步发布 8.0 版本,极少公开露面的集团 CEO 梁汝波登台。
飞书不是做失败了才被拆。它 2025 年营收超过 30 亿元,同比增长约六成;2026 年二季度同比增速超过 100%;新增客户里,超过九成同时采购了飞书的 AI 产品。行业里已经有人判断,飞书有望在 2026 年内做到国内企业协同市场收入规模第一位。
但同一份材料里还有另外几个数字:飞书团队约 4000 人,行业测算对应的年人力成本在 32 亿至 40 亿元之间;月活约 3000 万,不足钉钉的七分之一;谢欣曾把飞书的盈利目标拉长到 2030 年。
把两组数字放在一起,那个「为什么」就有了形状:一个还在高速增长、却仍需自己输血数年的业务,被拆成两半,分别并入 AI 与云。方向只能有一个——在字节的计算里,飞书作为「独立产品」的价值,已经低于它作为「入口的一块拼图」的价值。
这封邮件只是一条线索。顺着它往下看,是一张牌桌,和一个把十年攒下的筹码整批推上去的赌局。
牌桌上的牌,越看越像
先说清楚一件事:这一代大模型本身,正在被极快地商品化。
第一梯队是 GPT-5.6 系列的 Sol 与 Claude 的旗舰;第二梯队是 GPT-5.6 的 Terra、Luna 两兄弟,加上 DeepSeek V4.1 Flash、Qwen3.8、Gemini、月之暗面、智谱,以及豆包的 Seed 系。梯队之间的差距只有半档,各家在多模态、工具调用、长上下文上的能力清单高度重叠。
更关键的是速度与价格。DeepSeek V4.1 Flash 在实测中达到约 250 tokens/秒的出字速度(实测数据,经本地接口调用所得,非官方基准),同时具备多模态,价格明显低于同级竞品。
当「又强、又快、又便宜」三件事同时成立时,模型能力就很难再单独构成收费壁垒。被压缩的是模型层的利润空间,被喂肥的是掌握入口与数据的公司。
所以牌桌上的真问题从来不是「谁的模型最强」,而是「谁能把模型变成入口」。模型是弹药,入口是枪。
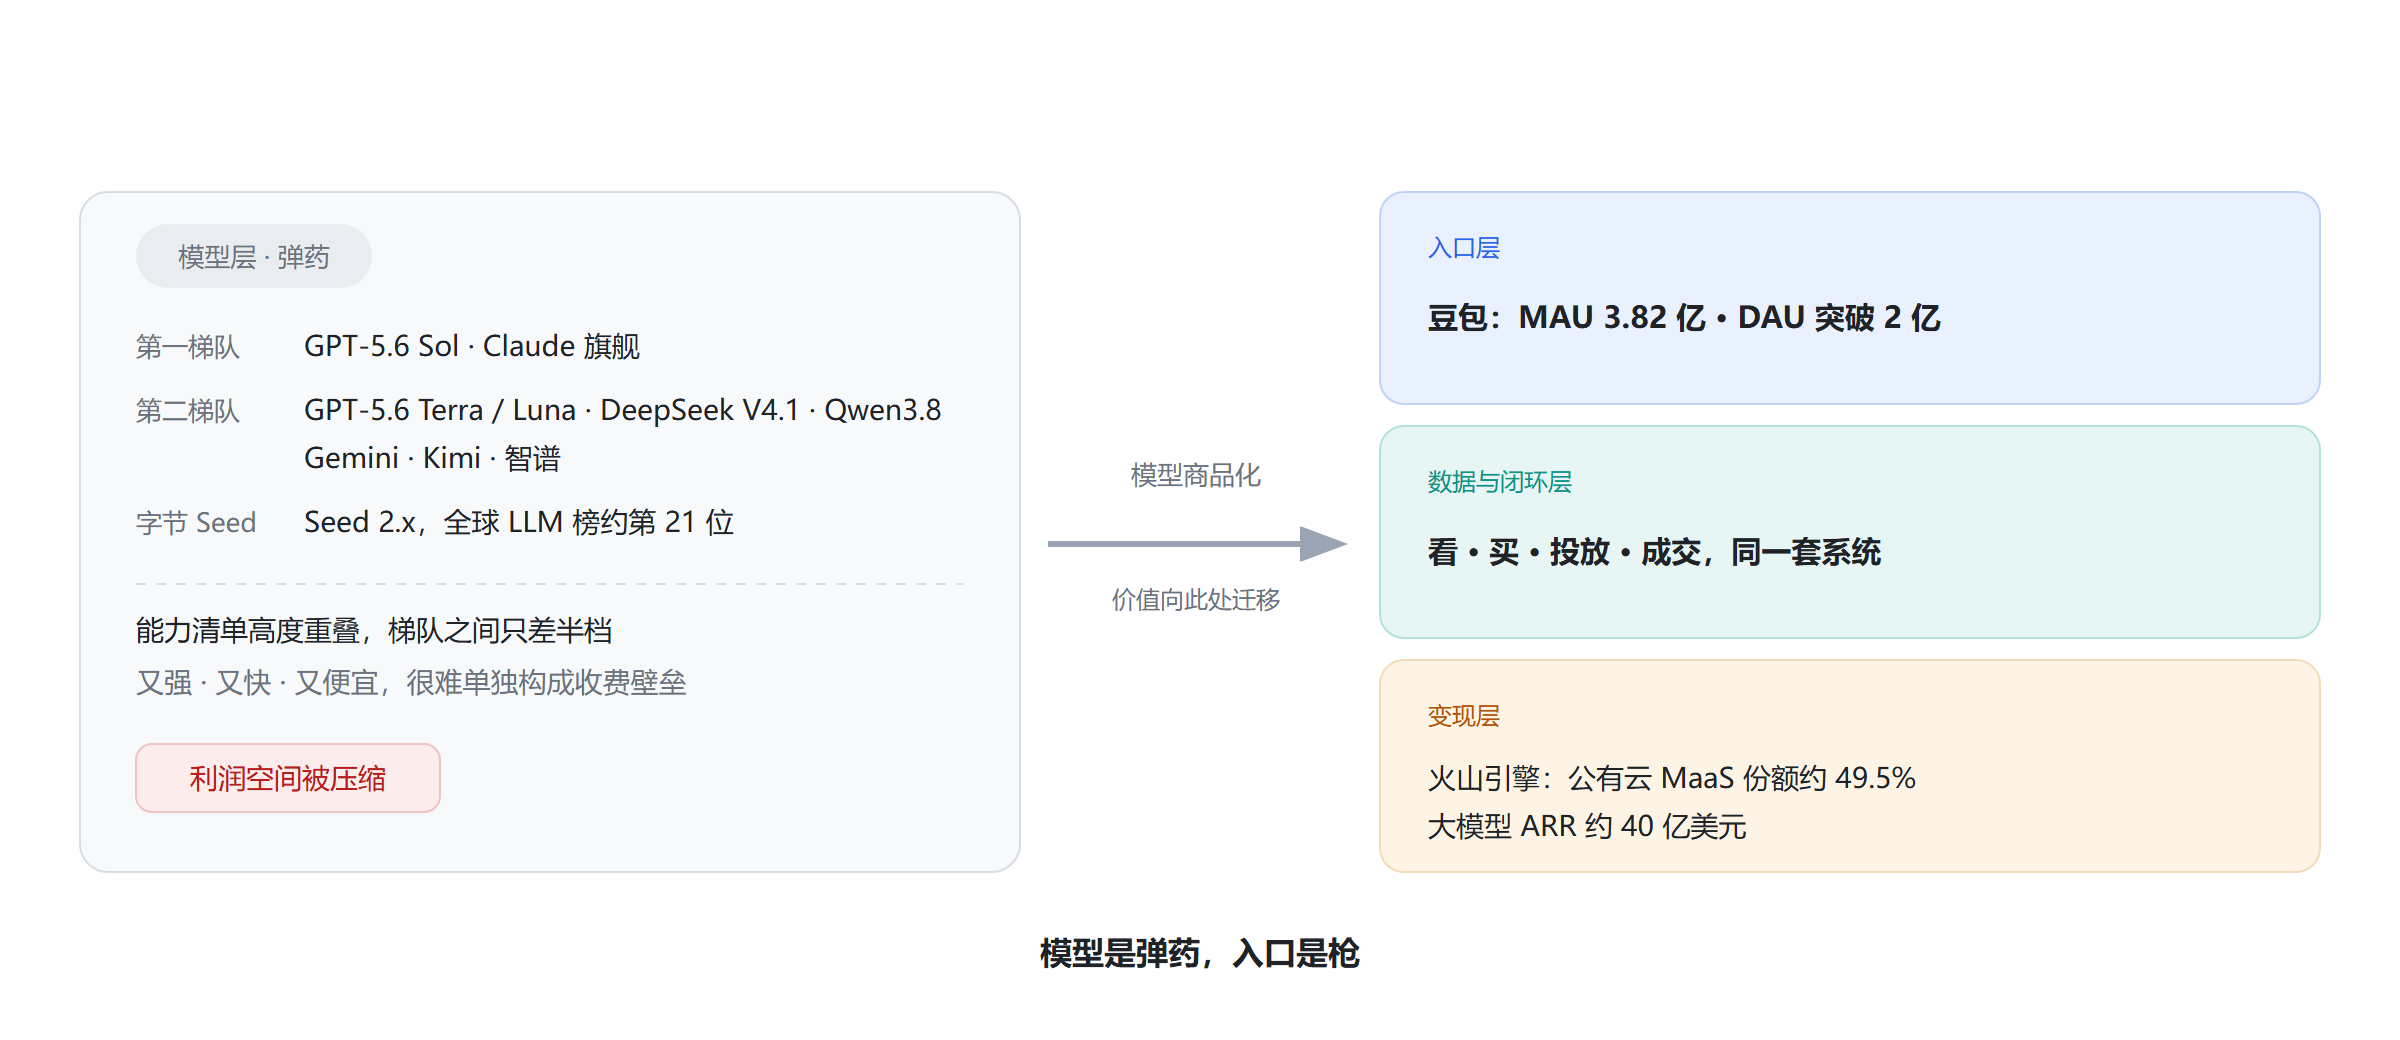
而在弹药这一项上,字节并不是领先者。据公开报道,其 Seed 2.0 / 2.1 Pro 在全球 LLM 排行榜上约处第 21 位;按第三方评测口径,它落后于月之暗面、阿里、智谱与 DeepSeek。梁汝波在 8 月 6 日的全员会上也承认,大语言模型上被海外领先模型拉大了差距。
但他手里握着另一副牌。
两头牛,一头在境内,一头在境外
要理解这场赌局的胆量,得先看它的钱包。
存量那一条牛在境内。 抖音依然是集团的收入主来源,国内业务贡献约七成营收——规模大,但增速已经放缓。
增量那一条牛在境外。 据《The Information》2026 年 9 月的报道,字节 2026 年上半年营收约 1200 亿美元,同比增长约 30%,主要受 TikTok 等海外业务推动;海外收入占比从 2024 年的约 25%、2025 年的约 30%,到 2026 年上半年突破 30%,再创历史新高。2025 年海外营收增长接近 50%,而国内约为 20%。TikTok Shop 在 2025 年的活跃消费者约 4 亿、GMV 接近千亿美元;到 2026 年上半年,其全球 GMV 约 503 亿美元、同比增长 92%,其中美国市场约 118 亿美元。
一条看存量,一条看增量。存量养的是现状,增量决定的是能撑多久。对一场需要持续追加弹药的豪赌而言,增速才是燃料——字节敢把注下这么大,本质上赌的是 TikTok 这条通道能持续输血。
但这条通道不完全在自己手里。
TikTok 与抖音的关系要分两层看。运营层是「一家人」:TikTok 是抖音的国际版,由同一集团实际运营,共享算法与技术栈,账号体系与国内抖音完全隔离。资本层则被美方的监管框架牢牢套住:
- 2024 年 4 月,美国立法要求字节跳动剥离 TikTok 美国业务,否则将面临禁用;
- 2025 年 9 月,美方签署行政令推进交易,副总统万斯给出的相关合资公司估值约为 140 亿美元;
- 2026 年 1 月,交易完成交割:Oracle、Silver Lake、MGX 各持约 15%,字节保留近 20% 股份,新实体独立运营,算法在美方云环境下依据美国用户数据重新训练。
这里有一个需要澄清的常见误读:140 亿美元是「TikTok 美国数据安全合资公司」的估值,并非 TikTok 美国整体业务的价值;后者外界估算约在 300 亿至 400 亿美元区间(彭博)。作为量级参照,字节自身估值约 3300 亿美元,而追踪二级市场交易的机构给出的估值已到约 6300 亿美元。
所以准确的说法是:字节握着一条现金流最猛、却也最难控的通道。它既是 All-in AI 的关键弹药来源,也是这家公司全局最强的单一外部不确定性。
赌本不在钱包里
现金买的是弹药,真正的赌本是数据。
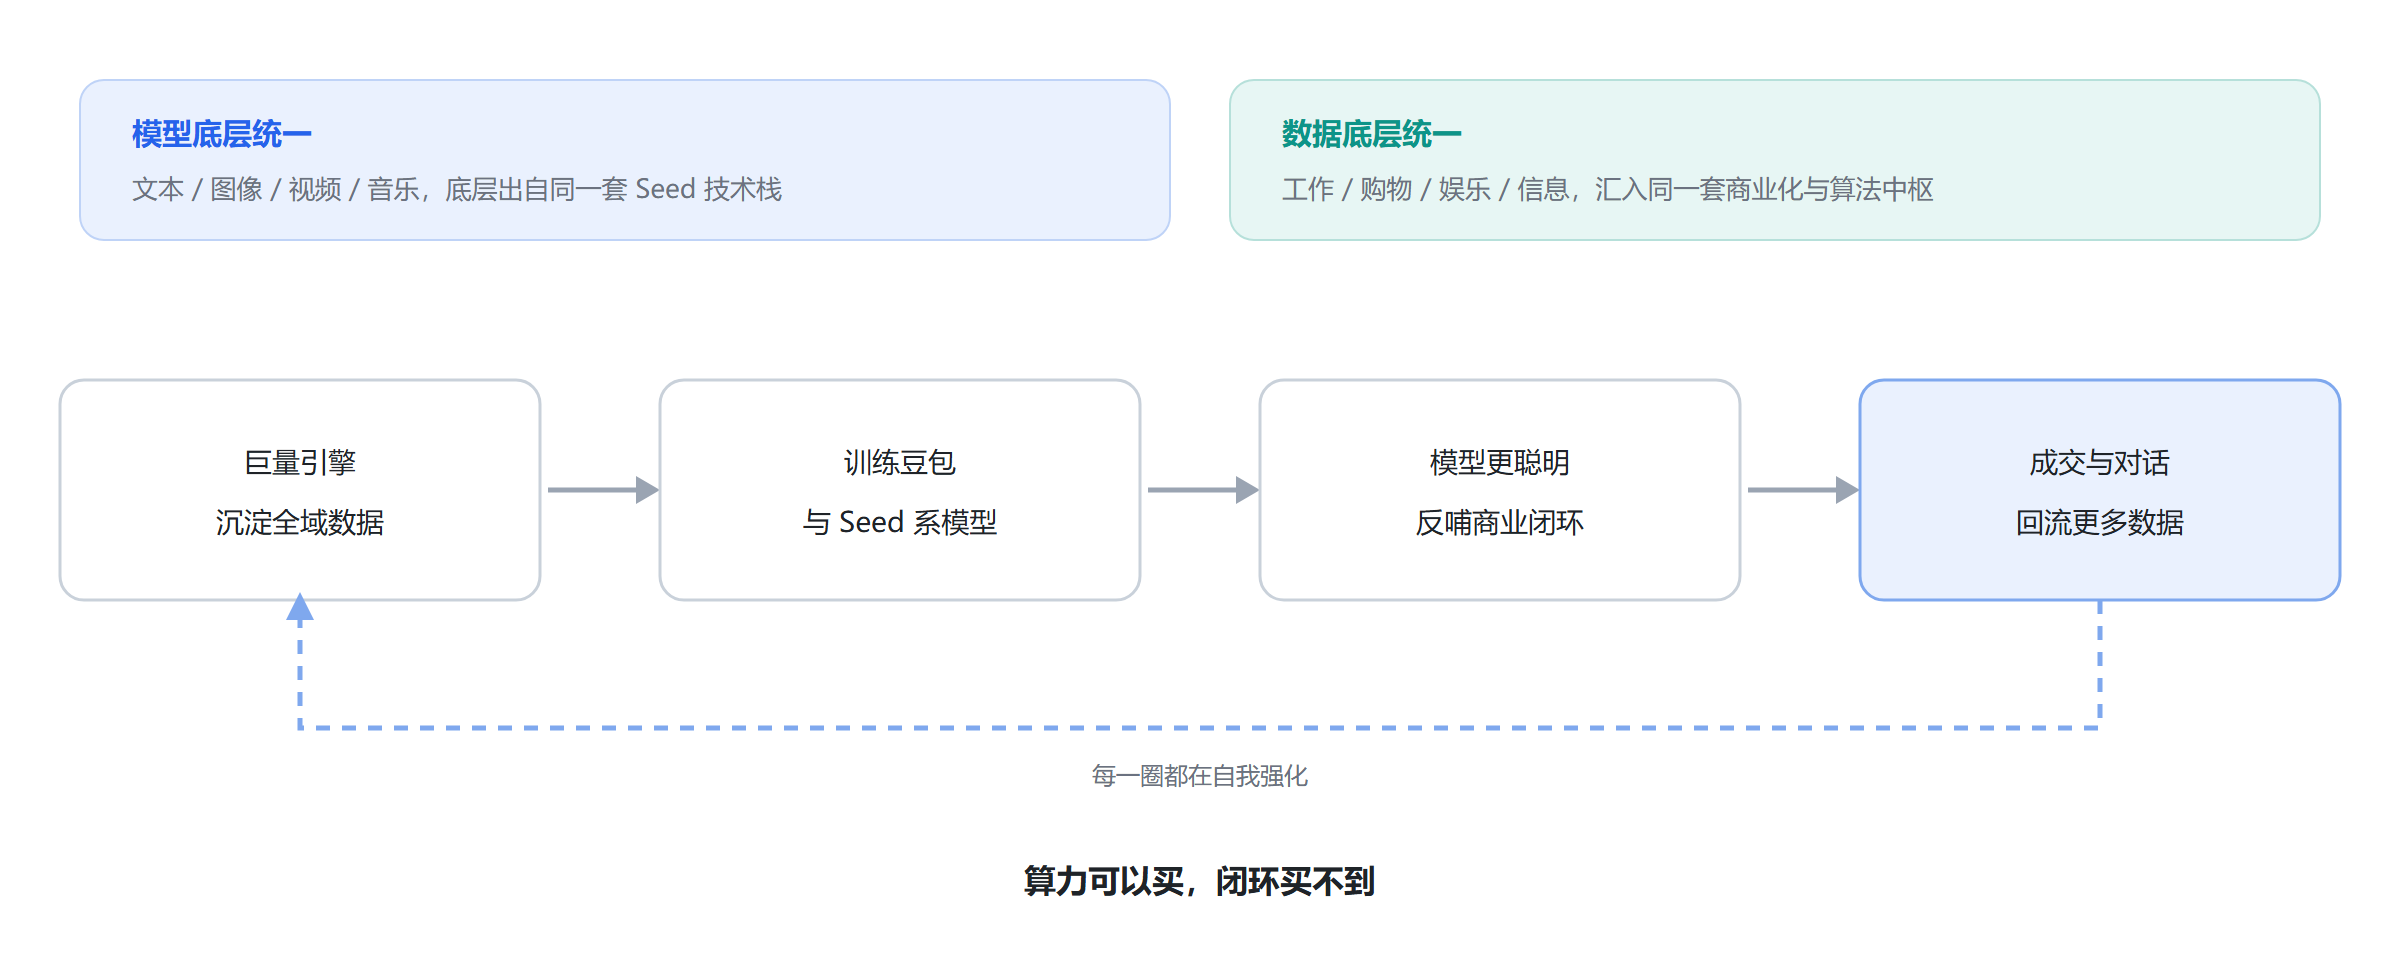
字节商业化的底层是巨量引擎(Ocean Engine),连同巨量云图、算数、千川以及 Buyin 等组成统一中台,服务内容、电商、广告主与用户画像的一体化经营。这套系统很早就把「商业化数据中枢」打通了:看视频的人、买商品的人、被投广告的人,落在同一个用户池、跑在同一套决策引擎上。
这里要说清两层「底层统一」,它们经常被混为一谈:
- 模型底层统一:文本、图像、视频、音乐等所有 AI 能力,底层出自同一套 Seed 系模型栈;
- 数据底层统一:工作、购物、娱乐、信息全场景的行为数据,汇入同一套商业化与算法中枢。
两层合一,才是字节的完全体。飞书与豆包,只是最新接上去的两根电线。
数据为什么比算力更硬?看三个维度:
- 广度:工作、购物、娱乐、信息全场景入同一底座,不存在数据孤岛;
- 深度:停留、完播、搜索、加购、下单、退换、投诉、投放响应,构成真实意图的结构化全链路行为;
- 反馈:每一次成交、每一次投放、每一次客服对话,都是天然的偏好反馈信号。
于是形成一个飞轮:巨量引擎沉淀全域数据 → 训练豆包与 Seed 系模型 → 模型更聪明 → 反哺商业闭环 → 回流更多数据。
这套说法要经得起比较才站得住。OpenAI 拿巨额资金去买算力,这是它的路径;但 Google 手里有搜索、YouTube、Android 与 Workspace,Meta 有三十多亿用户的关系链,腾讯有微信——这些数据同样是买不到的。
所以真正的差别不在「有没有数据」,而在这份数据能不能直接落进一个交易闭环。字节独有的不是数据本身,是抖音这个场:一个人在看、在买、在被投放、在成交,四件事发生在同一套系统里。算力可以买,闭环买不到。
一棵树,只长主干
字节的产品史是一条主干不断分叉的历史:今日头条(图文与算法推荐)→ 抖音(视频)→ 抖音商城(电商)→ 豆包(AI 与多模态)→ 剪映、即梦、短剧(内容生态闭环)。每一步都复用上一步的资产:算法、用户、数据、内容生态、流量池。
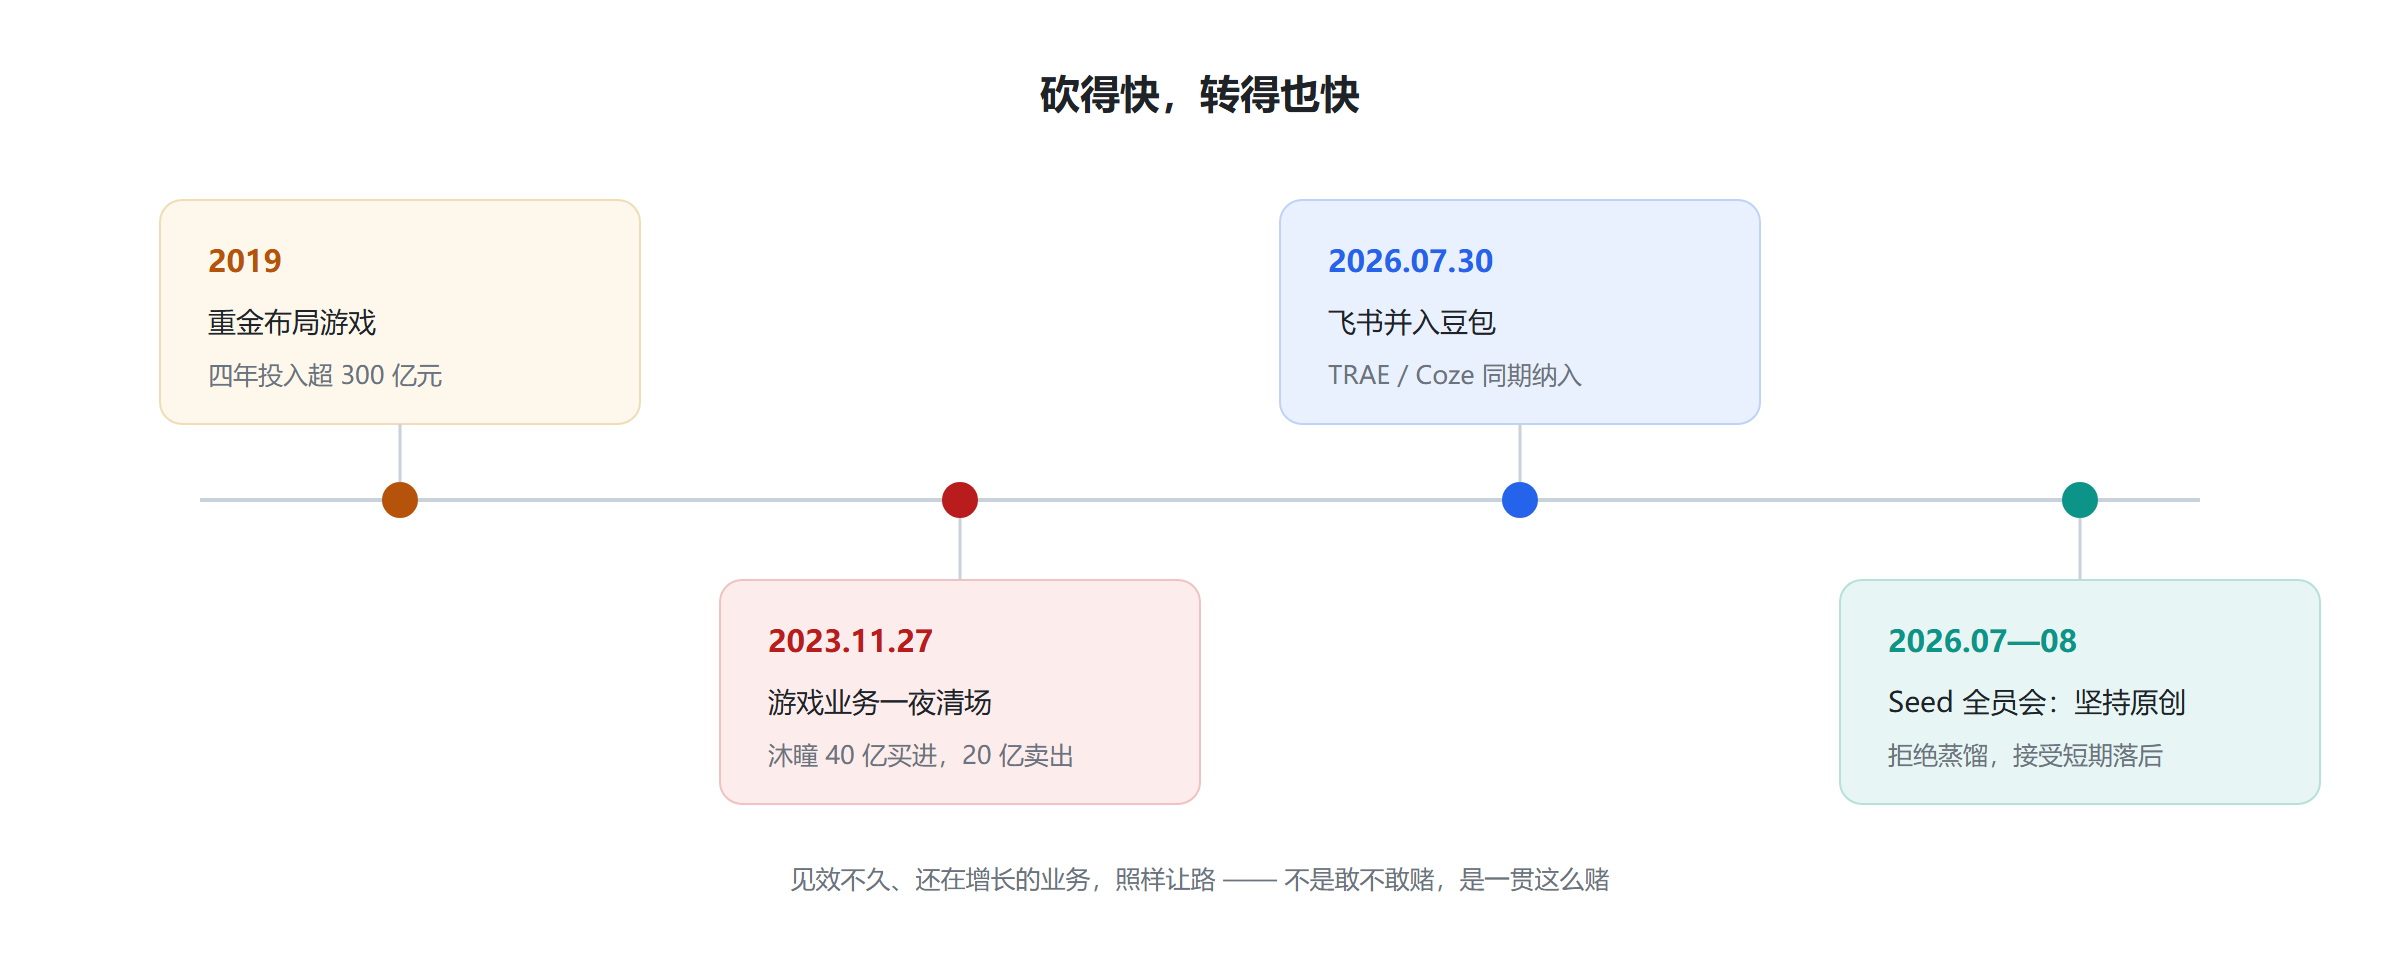
但分叉的另一面是剪枝,这一面常被忽略。这条主干上还长出去过不少枝:2019 年重金布局的游戏,四年投入超过 300 亿元,2023 年一夜清场;更早的教育业务,也在政策与战略的双重挤压下收缩。
所以更准确的说法不是「字节几乎没有回头收网的债务」,而是——它从不试图收网,它直接剪枝。 付出的代价是沉没成本,换回来的是主干始终不被拖累。收敛成本低,不是因为从不撒网,而是因为舍得砍。
豆包不是模型,是一台路由器
豆包常被误解成「一个大模型产品」。用本地一手抓包(2026-09-20,从桌面客户端真实流量中读出,非推测)看,它的内部结构是另一回事:
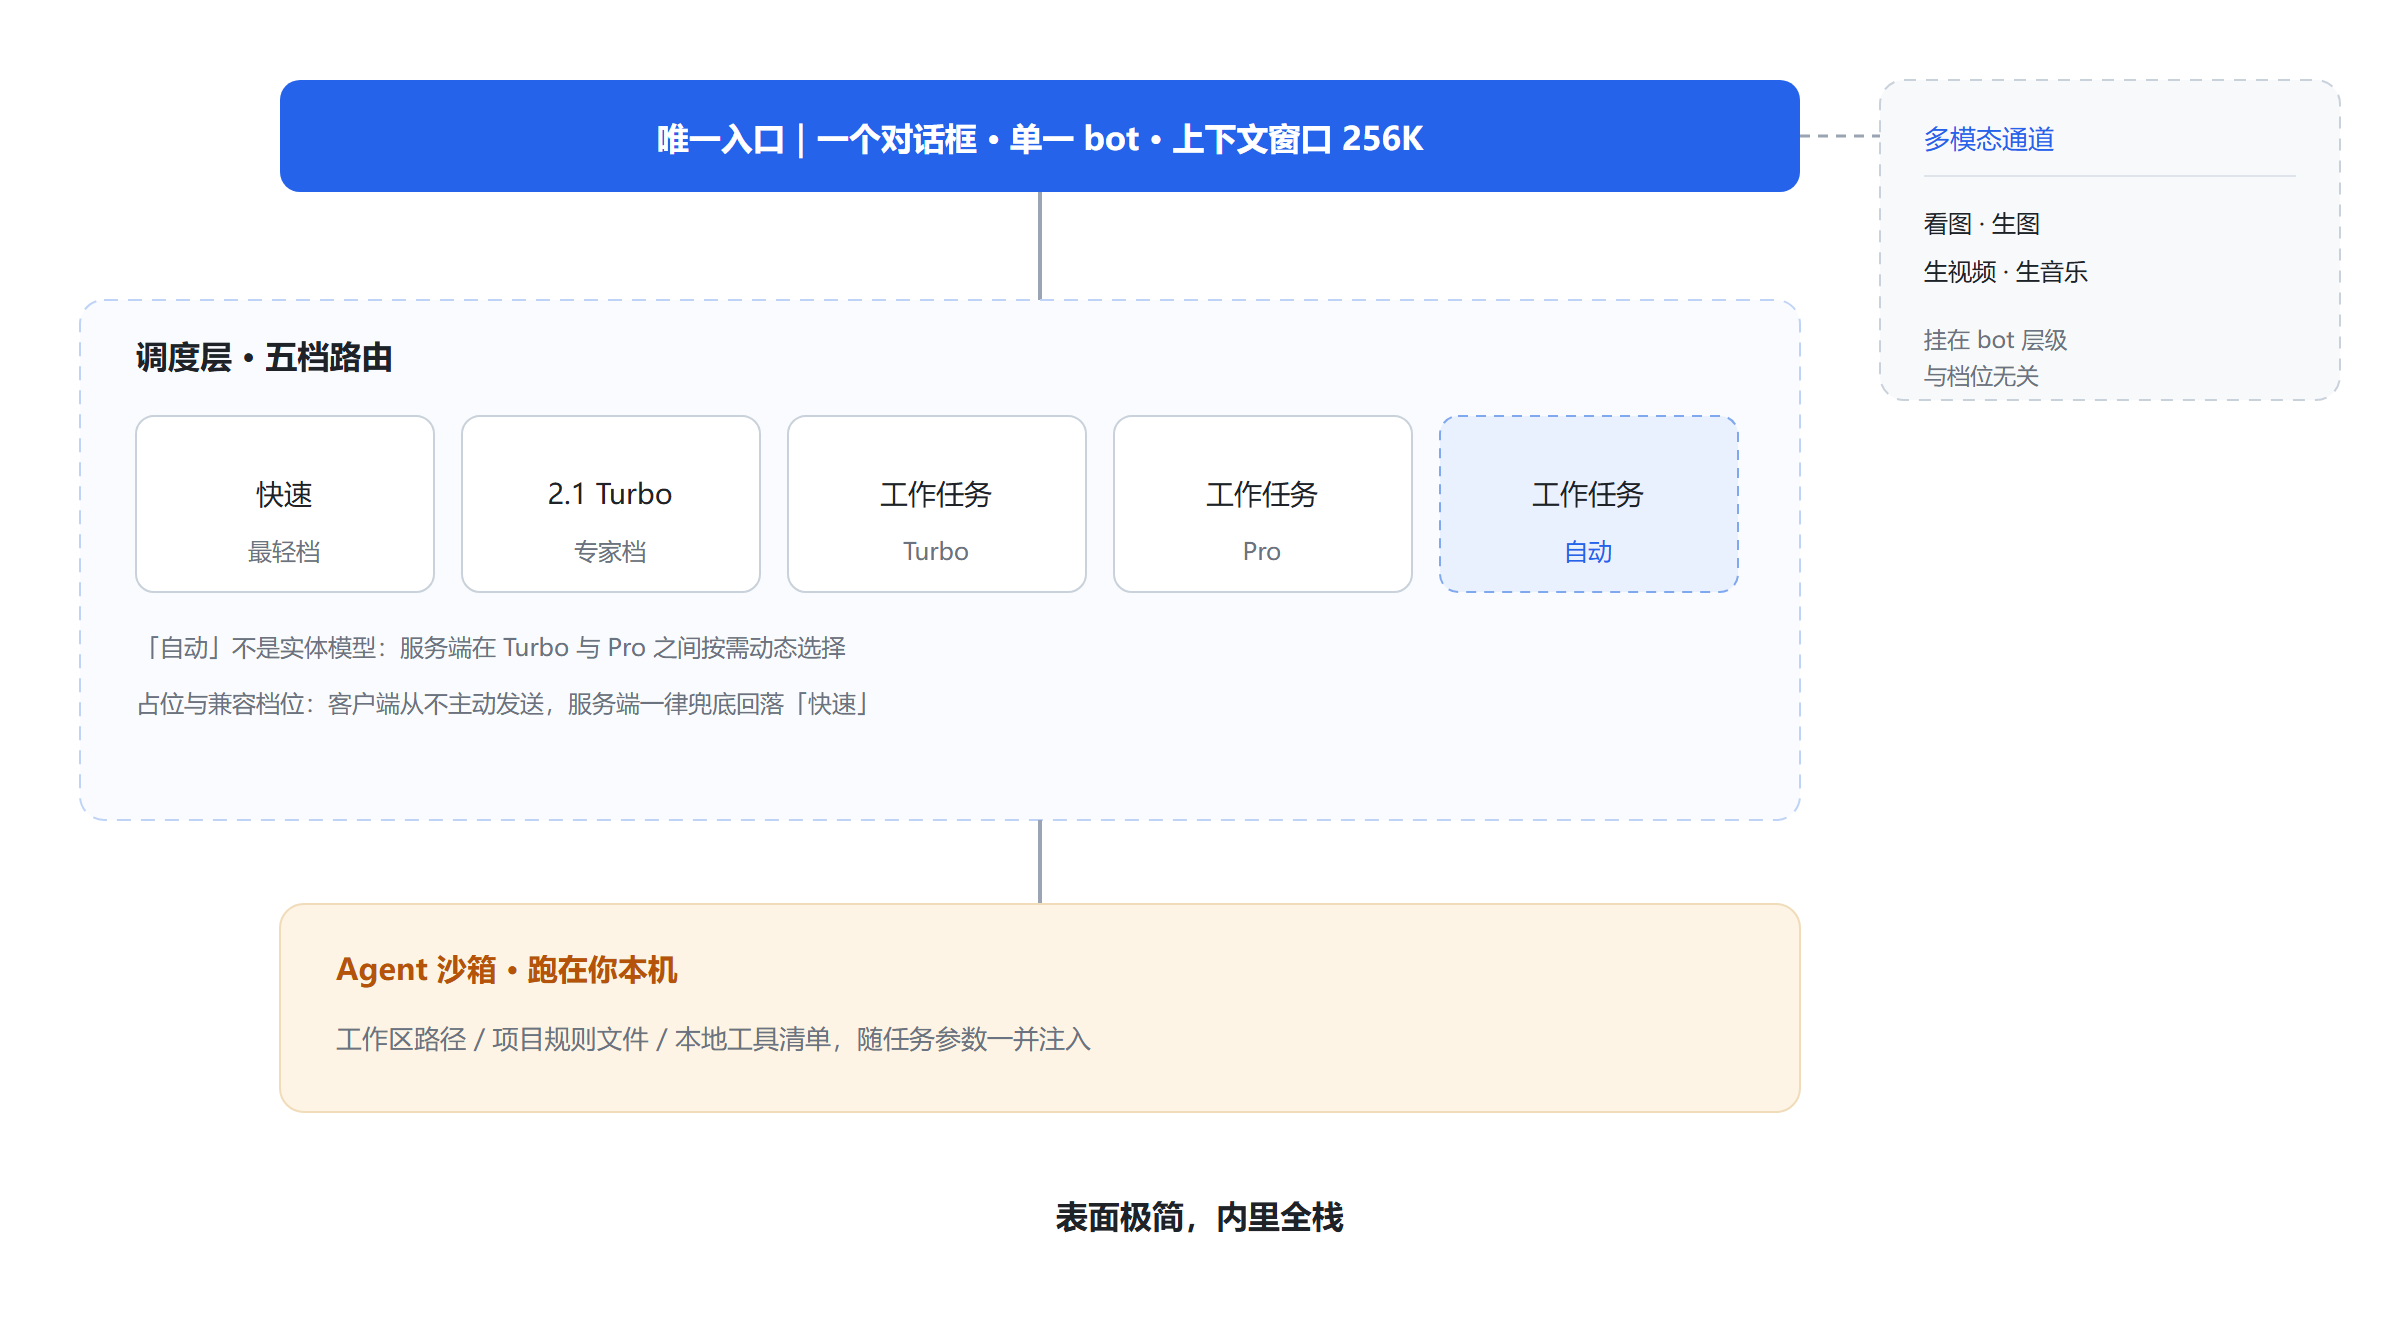
- 唯一入口:桌面端所有对话(含工作任务档)都走同一个接口端点,同一个 bot 贯穿全部档位。一个 bot 就是一个收口点。
- 五档路由:界面上的「快速」「2.1 Turbo 专家」「工作任务 Turbo」「工作任务 Pro」「工作任务 自动」,对应五组路由参数;其中「自动」并非实体模型,而是服务端在 Turbo 与 Pro 之间按需动态选择。换句话说,用户看到的是「一档自动」,背后是一次实时选模型。
- 占位档位全部回落:另有若干占位或兼容档位,客户端从不主动发送,服务端一律兜底回落到最轻的「快速」档。对外永远只暴露「一个简单对话」。
- 多模态是平台级通道,不是档位能力:看图、生图、生视频、生音乐与档位无关——输入走附件通道,输出是以产品功能项的形式挂在 bot 层级上。档位之间真正的差异只有两项:思考档位是否可调、是否具备 Agent 工具沙箱。
- 沙箱跑在你本机:工作任务档会把工作区路径、项目规则文件与本地工具清单注入任务参数。也就是说,交给模型的不只是那段对话,而是「你本机的上下文」。
- 上下文窗口 256K(抓包读出的配置值)。
把这些拼起来,得到的是一个「表面极简、内里全栈」的结构:用户只面对一个对话框,复杂度全部沉到调度层。这正是「聚合到一点」在单个产品上的最小单元演示——精简,从来是极致的复杂的另一种说法。
而这台路由器正连着一份惊人的体量:据 QuestMobile,豆包 2026 年 6 月月活约 3.82 亿,居国内 AI 原生应用之首,超过千问与 DeepSeek 之和,日活突破 2 亿;官方口径下,其日均 Token 调用量已突破 180 万亿,过去一年增长超过 10 倍。
规模领先,收入却是另一回事——据晚点 latepost 报道,豆包日收入不足百万元。这正是后面要说的事:路由器的流量越大,越需要一个出口。
飞书从产品降为工具
回到那封邮件。飞书并入豆包,不是两个产品做合并,而是让飞书从「独立产品」降维成豆包可调用的工具集。
- 产品线:飞书产品团队并入豆包团队,豆包成为「头」,飞书成为「手」;
- 商业化线:飞书的销售与服务体系并入火山引擎,与底层算力业务合并;
- 整合范围不止飞书:同期,AI 编程工具 TRAE 与 Coze 也一并纳入豆包体系;
- 落地形态:整合后的「豆包工作」可以用用户既有权限内的飞书文档、组织架构、OKR 等企业资产作为上下文,完成检索、分析与多步骤任务,再把成果带回飞书协作。
这套范式的形状是:豆包是唯一前台,业务是被调用的无头工具。 用户只有一个接触面,复杂度从「给用户」变成「给 Agent」——豆包保留轻,飞书保留全。
它已经跑起来了。一个一手目击的样例:在飞书搜索框里检索某个群聊中的人名,结果由豆包接管输出——语义理解、跨群检索、按时间与主题结构化梳理、给出带结论的摘要与线索入口,速度极快。这不是 App 之间的互相跳转,是底层调度与数据层的打通:飞书的数据,正在从「给你用的 App」变成「喂给豆包的数据层」。
但字节在这个赛道上不是先行者。 据易观《中国办公智能体平台市场研究报告 2026》,2026 年 6 月国内主流桌面端 AI 原生办公智能体平台月访问量突破 6000 万次,其中腾讯 WorkBuddy 以 2097 万次居首,超过第二、第三名之和;第二是字节的 TRAE IDE,第三是阿里的 QoderWork。阿里已把 QoderWork 等产品整合为「千问办公」,另有一款多 Agent 协作平台在内部测试;腾讯也在把模型、应用与渠道资源向办公 Agent 集中。巨头们做的是同一件事:从「赛马」转向「合兵」。
撒网的人,与守成的人
为什么字节选「主干分叉 + 收口」,而不是别的路径?先看两个反例。
Meta 是撒网式扩张。 Facebook、Instagram、WhatsApp、Messenger 四个入口并列,能力互相重叠;账号、数据、广告系统在下层早已统一,上层入口却故意不聚合——因为多入口意味着多广告位,聚合等于自砍现金流。它在元宇宙上重注 Reality Labs、烧掉数百亿美元后抽身,转向 AI 追赶。它手里有模型(Llama、Muse 系),却没有一个「豆包式」的唯一入口。
腾讯是主干正确、分叉乏力。 QQ 到微信是一段教科书式的递进,但到了微信就基本停住:视频号、小程序、支付都只是给微信做功能增益,没有长出新主干。守着社交、通讯与支付的超级主干,舒适区足够厚,反而不愿为 AI 冒险——元宝是嵌在微信里的功能位,不是独立入口。
两条路都指向同一个结论:在 AI 这轮里,入口必须独立存在并且足够收敛,否则组织的整合能力会在关键窗口里被自己的舒适区分食掉。
底牌不在产品里
打法可以学,底牌学不来。
业务是节点,不是孩子
字节的创始人张一鸣是程序员与架构师出身,这套思维贯穿了公司的组织方式:业务是主干上的节点,不是需要养大的孩子;该并入就并入,该砍就砍。
最能说明问题的一役发生在 2023 年 11 月 27 日。字节宣布收缩并重整游戏业务:
- 自研与发行品牌朝夕光年当天开始裁撤;已上线且表现不错的游戏(《晶核》首周流水近 7000 万元、在畅销榜霸榜近一个月,《星球:重启》上线即进入畅销榜前十)在保证运营的前提下寻求剥离,未上线项目除少量创新与技术项目外一律关停;
- 2021 年以约 40 亿美元从腾讯手中购入的沐瞳科技被列入出售计划,而意向买家报价仅约 20 亿美元。
需要纠正一个常见的归因:据公开报道,这一决策由 CEO 梁汝波与朝夕光年负责人严授讨论后拍板,其逻辑是游戏业务不聚焦、资源分散,应把精力投入更基础、更创新、更有想象力的项目。
它的反常之处在于「赢着也砍」。 刚做出成绩、正在霸榜的业务,说弃就弃;40 亿买进来的资产,20 亿也认。四年投入超 300 亿元人民币的赛道,一夜之间清场,随后全力转向 AI。
这不是孤例。2026 年 7 月的飞书整合,是同一套逻辑的第二次上演:见效不久、还在增长的业务,照样让路给更有想象力的主干。
把时间线连起来看——2019 年布局游戏、2023 年一夜清场、2026 年整合飞书——字节「砍得快、转得也快」的决策速度,才是它敢喊出「史上最大押注」的组织底气。不是敢不敢赌的问题,是它一贯这么赌,而且每一刀都利落。
(说明:「史上最大押注」这一表述在媒体与业内广泛流传,但目前公开资料并不足以证实其为张一鸣本人的原话;本文将其作为外界对该战略量级的描述使用。)
收租的人,不自己开店
游戏业务被砍掉时,最容易被提出的反驳是:那字节不是把自己的广告收入也砍了?
从「收租」的角度看,恰恰相反。
游戏行业如今要靠买量才能活,而买量的主渠道在抖音。对字节而言,有没有自营游戏业务,对整体营收影响不大——游戏公司赚多少钱,都要向它缴纳一笔「买量税」。这笔税的主要缴纳者是外部大厂,自营游戏在自家平台的买量份额只是零头,还要背上重资产的研发成本,相当于「自己开店也要给自己交租」。砍掉自营,是甩掉双重成本、保住外部税基的选择。
更进一步,买量早已从固定价演变为竞价拍卖(按转化出价),税率随竞争自动上浮。平台本质上是一台收税机,买方竞价、卖方坐收,这是平台经济天花板最高的收法。抖音的这台收税机,同样压在电商投流、本地生活到店投流、短剧投流,以及直播打赏与电商佣金的分成头上。
一手数据(个人后台观察): 同样是买量,产品注册成本从 2019 年的 1 至 2 元/注册,涨到 2026 年的 60 至 70 元/注册,七年间增至约 30 至 70 倍,折算复合年化约 60% 至 85%。2019 年抖音刚完成用户爆发、商业化仍处圈地招商期时,广告主少、竞价温和,平台还在补贴早期投放者;这类低价买量冷启动的黄金窗口大约只存在于 2019 至 2022 年,2023 年起竞价快速抬升,到 2026 年窗口基本关闭。
这也是中国流量平台共同的剧本:早期减租圈佃户,地皮聚拢之后涨租并竞价拍卖。腾讯 QQ 空间的页游时代如此,淘宝从免费开店走向竞价直通车亦是如此。收租逻辑从未改变,变化的只是税基的形态。 押注 AI 对话入口的本质,是想把税基从「门户流量」扩展到「对话即办事」的下一代入口。
三个对照者,三种活法
把字节与三个对照者并排放,差异一目了然:
| 公司 | 扩张形态 | 依托优势 | 最大风险 | AI 姿态 |
|---|---|---|---|---|
| 字节 | 主干分叉 + 收口 | 用户规模第二、在线时长第一 | 资金消耗无上限 | All-in |
| Meta | 撒网式 | 用户规模第一(去重后约 33 亿) | 入口难聚合 | 守成 + 局部布局 |
| 腾讯 | 主干正确 | 微信的分发权 | 分叉乏力 | 守成等待 |
| 小米 | 创始人 All-in 汽车 | 智能家居硬件密度 | 其他战线停滞 | 整合启动晚 |
三个对照者,各有各的教训:
- Meta:技术不弱,输在组织形态——入口不聚,模型就没有独占的着陆点,只能「有模型没筷子」。
- 腾讯:腾讯对外是与字节的竞争,对内则是一群各占一摊的山头。微信是集团里的「独立王国」,有产品洁癖,能顶住商业化压力;集团想汇总数据喂给 AI,得先看各山头的脸色。整合能力,是 All-in 的前提。
- 小米:创始人 All-in 汽车(SU7 成功),代价是其他战线停滞——手机份额承压、IoT 未见大涨、AI 让位。它的模型并不弱:MiMo-V2.5 系列 2026 年 4 月发布,在 OpenRouter 上调用量居前列;2026 年 8 月澎湃 OS 4 的「超级小爱 2.0」才完成与 MiMo 的深度集成,小爱团队也为此重组。问题出在时间——字节 2023 年清场转向、2026 年完成整合,小米这一步比它晚了差不多一年。单线程的决策中心里,新战线与 AI 争的是同一份注意力,汽车赢了,AI 排队。
至于字节那一行的「用户规模第二、在线时长第一」,有据可查:QuestMobile 与野村的数据显示,2026 年 7 月抖音的月度总使用时长份额首次超过微信(19.4% 对 18.8%);把字节系所有 App 加起来,占国内 Top50 应用总使用时长的 40.9%,腾讯系为 29.1%。
这一注的对价
赌注越大,账单越硬。
钱烧得有多快
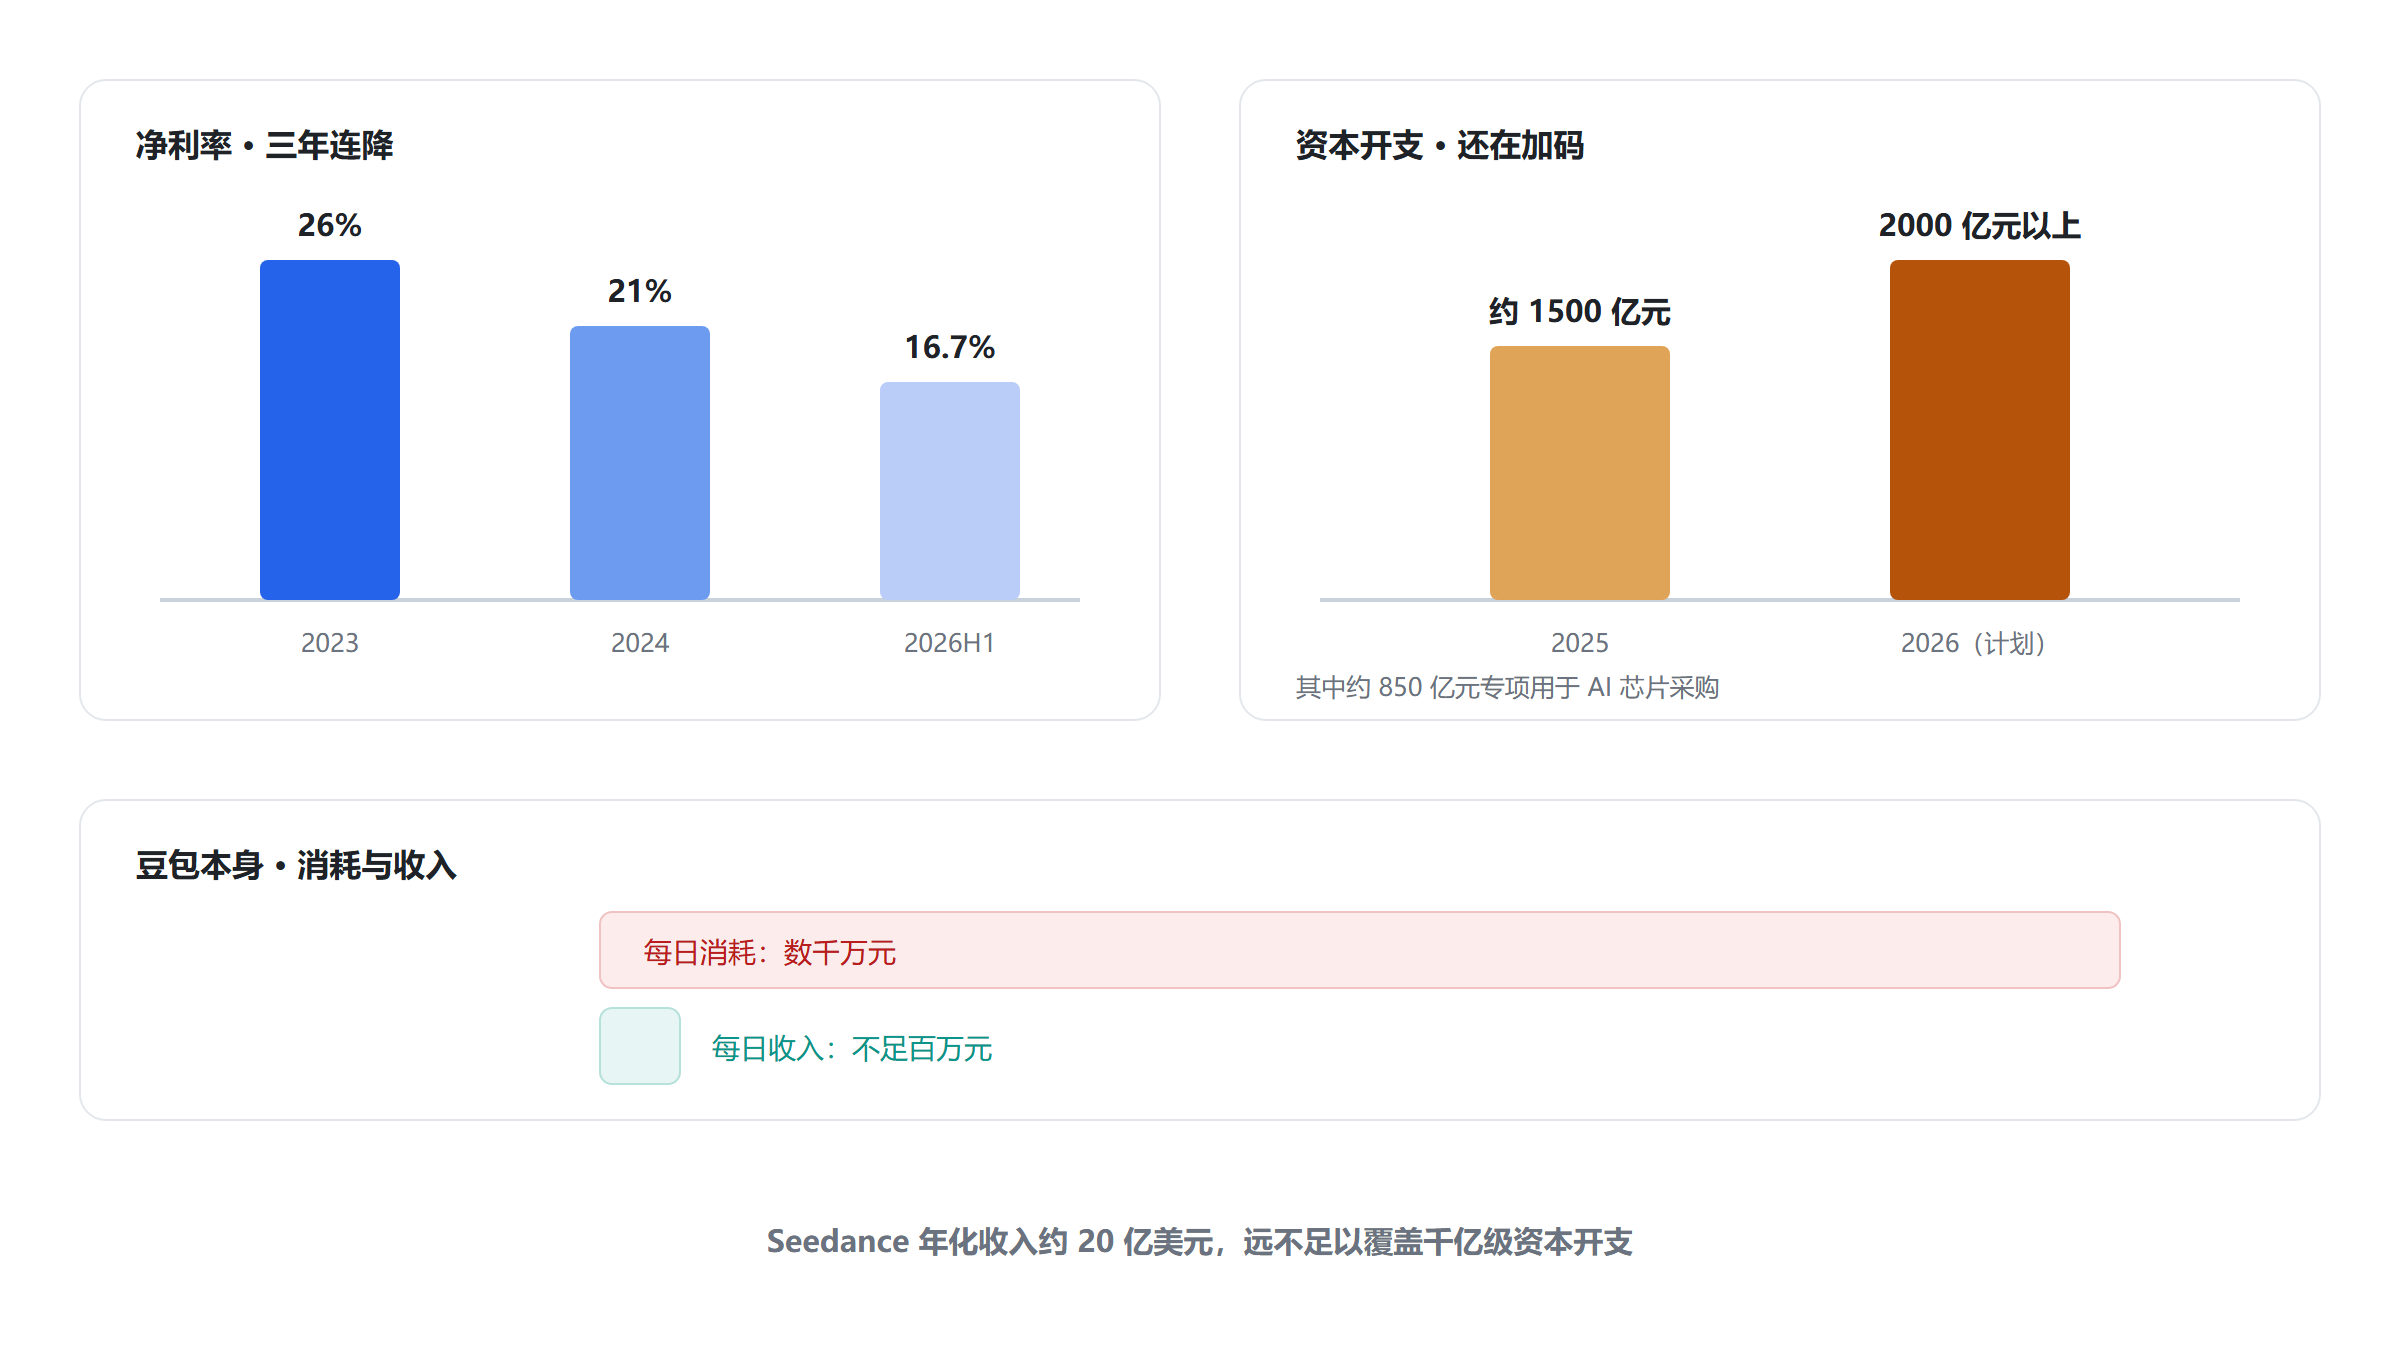
据 The Information 报道,字节 2026 年上半年营收约 1200 亿美元、同比增长约 30%,净利润约 200 亿美元,同比出现个位数下滑。更要紧的是趋势:净利率已连续三年走低,2023 年约 26%,2024 年约 21%,2026 年上半年约 16.7%。
钱花在了哪里,账面上写得很清楚。2026 年 9 月初,一笔约 296 亿美元的银团贷款落地,近 30 家银行参与,原计划筹资 200 亿美元、因认购踊跃最终扩大至 296 亿,成为 2026 年亚洲第二大美元计价银团贷款,仅次于软银为投资 OpenAI 筹得的 400 亿美元。资本开支方面,2025 年约 1500 亿元人民币,2026 年已上调至 2000 亿元以上,其中约 850 亿元专项用于 AI 芯片采购;另有将全年上限提高至 700 亿美元量级的讨论。几乎全部投向芯片、算力与数据中心。
豆包本身的账更直观:其 Token 消耗在 2026 年 3 月已突破 120 万亿,到 6 月进一步升至日均 180 万亿,过去一年增长超过 10 倍;有测算认为它每天消耗数千万元,而带来的收入不足百万元。目前字节 AI 体系中收入最明确的是视频生成模型 Seedance,年化收入约 20 亿美元、单月营收超过 10 亿元人民币——这已经是相当亮眼的数字,但远不足以覆盖千亿级的资本开支。今年 6 月起豆包开始收会员费、7 月对酒店订单收取佣金,都引发过争议,实际收入仍不尽如人意。
一句话:过去轻资产时代攒下的家底,正在被批量兑换成 GPU、机房、电力与折旧。
主动落后
字节在大模型上暂时落后,且是主动选择的结果。
2026 年 7 月底,久未公开参与内部业务的张一鸣出现在 Seed 团队的全员会上,只讲了一件事:坚持原创、拒绝蒸馏。据《The Information》与多家国内媒体报道,内部对开源模型严禁蒸馏,甚至以 API 异常检测与开源数据过滤来堵死这条路。他的解释是要团队「延迟满足感」——用别人的输出换一时的榜单排名,换不来真正的技术上限。8 月 6 日的全员会上,梁汝波把这套定调复述了一遍:接受短期落后,坚持自研与长期优化。
这条路更贵、更慢,代价也已经出现:据晚点 latepost 的播客披露,表态之后 Seed 团队走了几个人;字节则成立了与 Seed 同级的数据部门,去解决高质量数据的来源问题。
它换来的不是模型层的领先,而是模型层的自主权——权重、技术栈与迭代节奏都握在自己手里,这对一家要在全球不同市场做本地化的公司,是另一层保险。技术自主与短期排名之间,字节选了前者。
耐心的倒计时
字节的组织考核是快变量,产品体验的打磨是慢变量。这套文化在业务扩张期是优势,在需要长期烧钱、长期打磨的复杂产品上则是风险。
外界对豆包的批评也集中在这里:立项两年多持续投入,AI 板块除 Seedance 外尚未见到稳定的回头钱;同时产品开始收费测试、功能持续叠加。知乎上有高赞回答将飞书并入豆包解读为「把失败项目打包再利用,换办公赛道试跑通」——这个判断未必准确,但它指出的耐心问题是真的。
All-in 是真的,耐心的倒计时也是真的。
悬在境外的那把刀
最后回到境外那条通道。TikTok 美国业务的股权与算法安排均已由美方监管框架界定,这是字节当前最大的单一外部不确定性。押注能否走到终点,有一个前置条件:这条现金通道不被切断。
而在境内,还有另一条腿刚刚长出肌肉:火山引擎在中国公有云 MaaS 市场占据约 49.5% 的份额、位居第一;按 7 月平均消耗口径,字节大模型业务 ARR 已达约 40 亿美元,超过国内其他模型公司 ARR 的总和。它既是「模型能力变成企业收入」的唯一成熟出口,也是这场赌局里最容易被忽略的一极——入口吸引流量,云负责把流量变成合同。
结论:三个判断
第一,这一注押的不是模型,是入口。 模型层正在商品化,能力差距只剩半档,又强又便宜的模型会持续压缩模型层利润,把价值让渡给掌握入口、数据与闭环的一方,所以真正值得下注的是「谁能把模型变成入口」,而不是「哪个模型最强」。
第二,字节的胜算是结构性的,不是单点性的。 它同时握有两层统一:模型底层(同一套 Seed 技术栈)与数据底层(同一套商业化与算法中枢),再加上一个已经在跑的分叉—收口打法。这让它有资格去打一场「用入口调度一切」的仗,而不只是发布一个更强的模型。
第三,胜负取决于两个慢变量。 现金通道(TikTok)决定弹药能续多久,组织耐心决定复杂产品能不能被养到成熟。技术不是成败的唯一变量——Meta、腾讯、小米的对照已经说明,组织形态与收敛时机,往往比技术更能决定战略命运。
至于那个最常被问的问题:豆包会不会成为下一代入口?答案不取决于豆包今天的模型分数,而取决于字节能否在耐心耗尽之前,把「一个对话框背后的整台机群」真正变成用户的工作与生活默认入口。牌已经推上桌了。
附录 · 2026Q3 模型层快照
收录范围为「正文点名或作为直接参照的厂商旗舰」;模型迭代极快,下表以 2026Q3 检索信息为准,引用前请重新查证。仅对本人实测过的模型标注速度。表中「坐标」一列为本文口径(含个人体感),与公开评测榜的位次并不等同。
| 模型 | 厂商 | 坐标 | 备注 |
|---|---|---|---|
| GPT-5.6 Sol | OpenAI | 第一梯队旗舰(2026-06-27 发布) | 首 token 约 1.46s(慢档);深度推理上限高于 V4.1 |
| Claude 系 | Anthropic | 第一梯队 | 正文参照对象,未纳入本轮实测 |
| GPT-6 Astra | OpenAI | 下一代,官方有提及 | 依托 ChatGPT 入口 |
| GPT-5.6 Terra | OpenAI | 第二梯队上沿,Sol 的差异款 | 体感低于 DeepSeek V4.1 Flash |
| DeepSeek V4.1 Flash | DeepSeek | 第二梯队上沿,压在 Terra / Luna 之上、Sol 之下 | 约 250 t/s(实测)、多模态、价格低于同级 |
| Qwen3.8 | 阿里 | 国产第一梯队,综合均衡 | 多模态;工具与 Agent 适配广;体感高于 GPT-5.6 Luna |
| Gemini 系 | 第二梯队(体感在 GLM 之上) | 正文参照对象,未纳入本轮实测 | |
| GPT-5.6 Luna | OpenAI | 第二梯队下沿 | 三档中最弱;体感低于 Qwen3.8 |
| Kimi 系 | 月之暗面 | 第三方评测口径下领先于豆包 | 已进入办公智能体赛道 |
| GLM 4.x / 5 | 智谱 | 国产第二梯队 | 中文与长上下文有亮点;推理实战较前两者低半档 |
| 豆包 Seed 系 | 字节 | 全能型,强在工具、沙箱与产品承接 | 全球 LLM 榜约第 21 位;模型分数非其最强项 |
| Muse Spark 1.2 | Meta | 有模型,缺独占入口 | 多模态 + 工具 + Coding;缺乏独特护城河 |
关于个人体感口径(非公开评测结论):在本人实际使用中,DeepSeek V4.1 Flash 的位次高于 GPT-5.6 的 Terra 与 Luna,但仍低于 Sol;Luna 不及 Qwen3.8;Gemini 系不在第一梯队,大致落在 GLM 之上。国产阵营内部,DeepSeek 与 Qwen3.8 基本并列居前,GLM 次之。以上均为主观体感,差异在半档以内,不作为权威评测结论引用。