一張讓模型畫鵜鶘的排行榜,意外成了觀察推理模型三年進化最好的窗口。
2024 年 9 月,OpenAI 發佈 o1 時有個被反覆引用的細節:它會在回答前「思考」10 到 20 秒,當時用戶抱怨「像個打字很慢的學霸」。兩年後,GPT-6 Astra 拿到「畫一座夜晚燈塔」的考題時,可以「想」上整整 971 秒——十六分鐘。這中間發生的事,不是簡單的模型變強,而是整個行業對「智能」的定義方式變了:從「誰答得快」變成「誰肯多想、多想之後值不值」。
這篇文章用一條真實的橫切面資料——OpenRouter Sketch 榜(讓文本模型「一次成圖」的畫畫榜單,2026-10-04 經 NAS 上的「AI大模型排行榜」插件抓取)——把 ChatGPT、Claude、DeepSeek 三家的推理模型發展路程完整串起來。你會發現:推理能力的每一次躍遷,都清清楚楚寫在「成本」和「耗時」這兩個數字上。
第〇章 先搞懂:推理模型到底「多做了什麼」
在進入時間線之前,需要三分鐘理解一個概念:推理模型和普通模型的區別,本質上是「把回答變成一次計算過程」。
普通 LLM 拿到問題直接生成答案,一個字接一個字往外吐。推理模型(reasoning model)多做了兩件事:
- 思維鏈(Chain of Thought):在給出最終答案之前,先在心裡生成一大段「思考過程」——拆解問題、嘗試解法、自我檢查、修正方向。o1 的「思考 10 秒」,工程上就是生成了幾千個額外的思考 token。
- 強化學習(Reinforcement Learning with Verifiable Rewards, RLVR):訓練時不再只靠人類偏好打分,而是用有明確對錯的任務(數學題、代碼測試、競賽題)給模型的「思考過程」獎勵,逼它學會把算力花在刀刃上。
這套組合催生了一個新詞:測試時計算(test-time compute)。o1 的技術報告裡有一張關鍵圖:在推理任務上,模型的正確率(pass@1)會隨著「思考時間/思考 token 預算」的增加單調上升——這等於把「推理」本身變成了一條新的縮放定律(scaling law)。預訓練縮放定律說的是「資料越多模型越聰明」,測試時縮放定律說的是「想得越久,答得越準」。
於是整個行業出現了三個新的可調參數,它們是後面所有故事的主線:
- 思考強度(effort):低/中/高/最大,或多檔數值,控制「想多深」;
- 思考預算(budget_tokens):給思維鏈設定 token 上限;
- 模型路由(routing):系統自動判斷「這個問題該秒回還是該深想」。
「思考」從不可見的工程細節,變成了可以定價、可以調參、可以對比的商品維度。這就是為什麼後面所有數字都圍著「成本」和「耗時」轉。
第一章 2024 年秋:o1 按下「思考」鍵
推理模型的真正元年是 2024 年。9 月 12 日,OpenAI 發佈 o1-preview 與 o1-mini,內部代號「草莓」(Strawberry)。它和此前所有大模型的根本區別是:先把答案在心裡過一遍,再開口。
當時官方給的資料:在 IMO 國際數學奧林匹克資格賽上拿到 83%(GPT-4o 只有 13%);物理、化學、生物博士級基準超過人類專家。代價同樣肉眼可見——更慢、更貴,發佈初期一週只能用 30 條消息,聊天體驗被吐槽「像個打字很慢的學霸」。
o1 的技術意義在於驗證了兩件事:RLVR 可以規模化(用可驗證獎勵替代人類反饋,模型學會了自我糾錯);測試時計算可以規模化(給模型更多思考 token,正確率就漲)。12 月 6 日,支持多模態的 o1 正式版上線。
12 月 20 日,o3 在 OpenAI「12 天活動」收官夜亮相:ARC-AGI 視覺推理拿到 87.5%(人類基線 85%),數學、GPQA 全面破紀錄。ARC-AGI 這個榜單的特殊之處在於它測的是抽象推理——不給模型見過的題,所以「背題」沒用,只能靠真推理。
但故事在這裡拐了個彎。2025 年 2 月 13 日,奧特曼宣佈:o3 不單獨發佈了。推理能力將直接並進 GPT-5,因為 o1/o3 這類「獨立推理模型」要和 GPT 主系列合併成一個能自動切換思考與否的系統。o3-mini 成了 o 系列最後的獨苗(2025-01-31 上線,ChatGPT 首次向免費用戶開放推理模型)。
回頭看,o1→o3 這一年的意義:推理第一次成為可定價、可量化的商品維度,「思考多久」從工程細節變成了產品參數;而「要不要把推理做成獨立產品」的路線分歧,為後兩年的行業格局埋下了伏筆。
第二章 2025 年 1 月:DeepSeek 用開源撕開價格口子
如果說 o1 是「推理模型的 iPhone」,那 DeepSeek-R1 就是「安卓」——開源、可部署、論文級透明。
先看底座。2024 年 12 月 26 日,DeepSeek-V3 發佈:671B 總參數、37B 激活的 MoE 架構,配合多頭潛在注意力(MLA)、FP8 低精度訓練、多 token 預測(MTP),官方論文披露的訓練成本約 560 萬美元——這個數字當時讓整個硅谷重新算了一遍「訓練大模型到底要多少錢」。
2025 年 1 月 20 日,R1 與 R1-Zero 發佈,直接把推理模型的價格體系打穿:
- R1-Zero:全程不用人工標註,純靠強化學習(GRPO——群體相對策略優化,連 critic 價值模型都省了)把推理能力「長」出來。訓練日誌裡出現了著名的「Aha Moment」——模型自己停下來反思:「等等,等等,這是個值得標記的頓悟時刻……讓我重新評估一下這個解法。」
- R1:在數學、代碼上達到 o1 水平,按發佈時 API 定價折算,輸出價格約是 o1 的 1/27~1/30。權重 MIT 協議開源,還順手蒸餾出 Qwen、Llama 的小模型。
- 傳播效應:上架 7 天登頂美國 App Store 免費榜,直接把「OpenAI 該降價了」寫進全行業日程,全球 AI 芯片股一度劇烈波動。
R1 之後,DeepSeek 的迭代幾乎是一路踩著 OpenAI 的路線圖走的:
| 時間 | 版本 | 關鍵動作 |
|---|---|---|
| 2025-03 | V3-0324 | 推理增強,AIME 39.6→59.4 |
| 2025-05 | R1-0528 | AIME 70→87.5,GPQA 71.5→81 |
| 2025-08 | V3.1 | 一個模型同時支持思考/非思考雙模式——和 GPT-5 的「統一系統」思路撞了個滿懷 |
| 2025-09 | V3.2-Exp | 自研稀疏注意力(DSA),API 價格直接砍 50%+ |
| 2025-12 | V3.2 正式版 | 推理性能全球領先,拿下 IMO、CMO、ICPC、IOI 四塊金牌,首次把「思考」融進工具調用(Agent) |
| 2026-04 | V4 系列 | Pro(1.6T 總參/49B 激活)與 Flash(285B/13B),百萬 token 上下文標配,MIT 全開源 |
| 2026-08 | V4-Pro 正式版 | Agent 能力大幅增強(DeepSWE 62.7),原生支持 OpenAI Responses API,思考強度三檔 low/high/max;官方評測稱使用體驗優於 Sonnet 4.5、交付質量接近 Opus 4.6 非思考模式 |
| 2026-09 | V4.1-Flash | 全新架構,見下 |
V4.1-Flash(2026-09-10)是 DeepSeek 效率路線的一座里程碑:
- 架構:全新 Causal Encoder-Decoder(因果編碼器-解碼器)非對稱結構,552B 骨幹參數(另有 196B 稀疏記憶模塊),但 prefill 階段每 token 只激活 8B、decode 階段激活 16B——「讀」和「寫」用不同規模的計算,專為 Agent 這種「大量讀入、少量產出」的工作形態設計;
- KV Cache 壓縮:全局緩存壓到 890 字節/token(約為 V4-Flash 的 1/4),相對初代模型縮小 437 倍——緩存小,長上下文和 Agent 多輪任務的成本就斷崖式下降;
- 原生多模態:視覺理解併入主力模型(不再需要外掛 Vision 實驗版),45T 多模態語料預訓練;
- 成績:GPQA Diamond 90.9、Codeforces 評級 3471、Terminal-Bench 2.1 90.6、DeepSWE v1.1 74.2、CyberGym 88.1、AutomationBench 54.8;
- 定價:API 改名 deepseek-flash,閒時緩存命中輸入低至 $0.003/百萬 token,緩存未命中 $0.15,輸出 $0.6——比 V4-Flash 同檔再降 60%。
還有一個值得記住的行業插曲:DeepSeek 宣佈 2026-09-14 後 V4 Pro 下線、請求自動路由到 V4.1-Flash 並按 Flash 價格計費,官方理由是「繼續以更高價、更慢速度提供更弱的 V4 Pro 已不合適」。社區反應兩極:有人說「免費升級還降價」,有人說「我驗證過的生產工作流被 48 小時通知強切了」(對比 OpenAI 關停 Sora API 給了 6 個月預告)。這件事說明:當「便宜」變成公司戰略,連老用戶的遷移成本都會被算進效率賬本里。
DeepSeek 這條線的關鍵詞始終是效率:別人用算力換智能,它用架構換智能——MoE 稀疏激活、注意力壓縮、非對稱輸入輸出、KV 緩存瘦身。它把「頂級推理」的單價一路打到了閉源模型的零頭,也把「開源權重 + 論文透明」變成整個行業的定價錨。
第三章 Claude 的第三條路:混合推理 → 自適應思考
Anthropic 是三家裡面唯一在 2024 年沒有發推理模型的。CEO Dario Amodei 公開表態反對「快模型 / 推理模型」雙產品分裂,認為讓用戶手動選「要不要思考」是交互設計的失敗——這個立場直接決定了 Claude 之後三年的路線。
2025 年 2 月 24 日,Claude 3.7 Sonnet 帶著 Extended Thinking(擴展思考) 出場,被定義為「市場首個混合推理模型」:同一個權重,既能秒回、也能深度思考,要不要想、想多久,交給 API 參數 budget_tokens 控制。這是對 o1 路線的正面反駁——不分裂產品,把選擇權交給調用方。
後續演進都在打磨這個「思考開關」:
- 2025-05 Claude 4(Opus/Sonnet):思考期間能調用工具,還引入「思考摘要」機制(用小模型壓縮思維鏈,降低成本和延遲);
- 2025-08 Opus 4.1:編碼與長上下文提升;
- 2025-09/10 Sonnet 4.5 / Haiku 4.5:中端與入門檔補位;
- 2025-11 Opus 4.5:新增 effort 低/中/高三檔粗粒度控制,同時API 價格砍掉 66%($15/$75 → $5/$25)——推理模型的「貴」第一次被主動讓利;
- 2026-02 Opus 4.6:自適應思考(adaptive thinking)——模型自己判斷要不要想、想多深,手動模式開始棄用;
- 2026-04 Opus 4.7:手動模式徹底移除(返回 400),只留自適應 + xhigh 檔;
- 2026-05 Opus 4.8:Dynamic Workflows(並行子智能體編排)。
2026 年夏天,Anthropic 進入第五代,產品線也從「版本號」變成「角色分工」:
- 2026-06-09 Fable 5 / Mythos 5:首個 Fable 級模型,主打長週期 Agent 工作(曾因美國出口管制在 6-12 短暫停服,7-01 恢復);
- 2026-06-30 Sonnet 5:$2/$10,速度與智能的平衡檔;
- 2026-07-23 Opus 5:$5/$25,日常專業工作主力;
- 2026-09-01 Fable 5.1:自適應思考常開不可關閉(手動 disabled 直接 400),effort 五檔(low/medium/high/xhigh/max,默認 high),1M 上下文、128K 輸出,$10/$50,緩存讀取降到 $0.25(比 Fable 5 便宜 75%,長 Agent 會話成本大降);同權重受限版 Mythos 5.1 只對通過審查的機構開放(網絡安全/生物領域能力分級,類似 OpenAI 的受限訪問);
- 2026-09-22 Opus 5.5($4/$20)與 Sonnet 5.5($2/$10)補齊產品線。
到 2026 年 10 月,Claude 的定價階梯是:Haiku 4.5($1/$5)→ Sonnet 5.5($2/$10)→ Opus 5.5($4/$20)→ Fable 5.1($10/$50)。每一檔對應一種「思考強度」:從「最快秒回」到「自適應常開、默認 high」。
Claude 路線的本質:推理不是開關,是運行時資源。從「開發者在代碼裡擰 token 預算」到「模型自己按任務難度分配算力」,再到「分類器把高風險的請求降級到低能力模型處理」——推理的門檻一路下沉,而安全分級成為並行演進的主題。
第四章 GPT-5 之後:推理變成「自動擋」
OpenAI 的回應是 2025 年 8 月 7 日的 GPT-5:o 系列正式併入 GPT 主系列,ChatGPT 不再讓用戶選模型,而是自動判斷「該秒回還是該深想」——Auto 模式。GPT-5 的能力層覆蓋編碼、數學、寫作、視覺,被視為「統一系統」的完成形態。
此後 OpenAI 進入高頻小步快跑:
| 時間 | 版本 | 要點 |
|---|---|---|
| 2025-08 | GPT-5 / mini / nano | 統一系統,Auto/Thinking 雙模式 |
| 2025-09 | GPT-5-Codex | 面向 Agent 編程的專屬版本 |
| 2025-11 | GPT-5.1 | 編碼與指令遵循增強 |
| 2025-12 | GPT-5.2 | 質量與工具調用提升 |
| 2026-01~02 | GPT-5.2/5.3-Codex | 編程 Agent 專項迭代 |
| 2026-03 | GPT-5.4 / 5.4-mini/nano | 性能與成本分層 |
| 2026-04 | GPT-5.5 | 低成本檔性能逼近旗艦 |
| 2026-07 | GPT-5.6(Sol/Terra/Luna) | 能力層正式分三檔定價:Sol(旗艦)> Terra > Luna(入門),按任務複雜度路由 |
| 2026-09-03 | GPT-6 Astra | 官方稱「世界上最智能、最對齊的模型」,見下 |
| 2026-09-22 | GPT-6 Sol / Luna | 以不同能力×成本組合承接日常 |
| 2026-09-29 | GPT-6.1 Sol | 接近 Astra 能力,API 價格不到 Astra 一半($2/$10),並支持多智能體 beta |
GPT-6 Astra 是這段歷史的當前終點(2026-09-03 發佈,2026-09-22 前逐步放開全量):
- 規格:1.05M token 上下文窗口、128K 最大輸出,知識截止 2026-04-30,API 定價 $10/百萬輸入、$50/百萬輸出(緩存命中 $1);
- 跑分(OpenAI 官方自測):FrontierMath Tier 4 達到 98%(已幫助解決多個長期未解的數學開放問題)、ARC-AGI-3 99.9%、ExploitBench 100%、Terminal-Bench 4.0 57.9%(對比 GPT-5.6 Sol 37.3%、Claude Fable 5.1 55.8%,且官方稱單任務 API 成本分別低約 9% 與 63%)、GPQA Diamond 96.0%;
- 安全分級:首個在 OpenAI Preparedness Framework 下達到「Critical」網絡能力級別的模型——能自主發現並利用未知漏洞,因此同步上線了更嚴的安全棧、思維鏈全程監控和「失配監控」(misalignment monitoring);
- 對齊:54,000 個內部 Codex 任務模擬中,高嚴重度失配信號約為 GPT-5.6 Sol 的一半;
- 交互:支持異步工具調用、任務中途改指令(mid-turn steering)、對話中途調 effort;最低 effort 檔不再支持(Astra 不允許「完全不思考」)。
注意 OpenAI 這一段的兩個趨勢:模型命名從「版本號」變成「能力分層」(Sol/Terra/Luna、GPT-6 Astra/Sol/Luna/6.1 Sol),推理強度從「用戶選」變成「系統路由 + 會話中動態調整」。推理能力本身,正在從賣點變成基礎設施。
第五章 用 Sketch 榜給三代人拍張合影
上面是「官方敘事」,下面是「實測資料」。OpenRouter 的 Sketch 榜做了一件很妙的事:給幾十上百個文本模型同一個提示詞(「鵜鶘騎自行車」「夜晚的燈塔」「打傘的企鵝」……),讓它們直接產出圖像。文本模型沒有專門的圖像模型那麼強,但這個任務對「理解、規劃、細節執行力」的綜合要求,恰好是推理能力的試金石——而且它給每個模型都留下了可看的成品。
資料口徑(抓取於 2026-10-04,經 NAS 上 Halo「AI大模型排行榜」插件抓取緩存)
- 全榜 4 個提示詞欄共 640 條「模型 × 樣張」記錄,去重 204 個模型;默認欄「Pelican on a bike」參評 143 個模型(lighthouse 欄 173 個,全站最多);
- 該欄上游不給出質量分,主指標為單次成本(USD,越低越好)與生成耗時(秒);本文未自行加權合成任何「質量總分」;
- 全榜成本中位數約 $0.009~0.014、耗時中位數約 52~79 秒——也就是說,一次成圖的「市場均價」非常便宜,貴出來的錢全花在「思考」上。
三家旗艦代際的「成本 × 耗時」對照(默認欄)
| 廠商 | 代際(發佈時間) | 單次成本 | 生成耗時 |
|---|---|---|---|
| OpenAI | GPT-4(2023-03) | $0.043 | 5 秒 |
| OpenAI | GPT-4o mini(2024-07) | $0.00035 | 8 秒 |
| OpenAI | GPT-5(2025-08) | $0.099 | 106 秒 |
| OpenAI | GPT-5.5(2026-04) | $0.15 | 69 秒 |
| OpenAI | GPT-6 Astra(2026-09) | $0.87 | 391 秒 |
| Anthropic | Claude 3 Haiku(2024-03) | $0.002 | 13 秒 |
| Anthropic | Claude 4 Sonnet(2025-05) | $0.029 | 16 秒 |
| Anthropic | Claude 4.5 Sonnet(2025-09) | $0.034 | 25 秒 |
| Anthropic | Claude Opus 5(2026-07) | $0.5 | 275 秒 |
| Anthropic | Claude Fable 5.1(2026-09) | $2.13 | 519 秒 |
| DeepSeek | V3-0324(2025-03) | $0.001 | 26 秒 |
| DeepSeek | R1-0528(2025-05) | $0.004 | 94 秒 |
| DeepSeek | V3.2(2025-12) | $0.001 | 25 秒 |
| DeepSeek | V4 Pro(2026-08) | $0.055 | 214 秒 |
| DeepSeek | V4.1 Flash(2026-09) | $0.019 | 62 秒 |
來源:OpenRouter Sketch 榜(openrouter.ai/benchmarks/media/sketch,默認提示詞欄),2026-10-04 抓取;OpenRouter 資料按 CC BY 4.0 授權轉述。完整清單見下節。
三家族在默認欄的完整清單
把三家在默認欄所有參評模型攤開,演化脈絡更完整(按成本升序):
OpenAI(20 個):gpt-4.1-nano($0.00027/7s)→ gpt-4o-mini($0.00035/8s)→ gpt-oss-120b($0.00065/40s)→ gpt-5-nano($0.01/144s)→ gpt-4.1($0.017/24s)→ gpt-5.1-codex($0.018/14s)→ gpt-5.1-codex-mini($0.019/171s)→ gpt-5-mini($0.025/100s)→ gpt-5.6-luna($0.032/263s)→ gpt-4($0.043/5s)→ gpt-5($0.099/106s)→ gpt-5.1($0.11/101s)→ gpt-5.5($0.15/69s)→ gpt-5.3-codex($0.21/156s)→ gpt-5.6-terra($0.29/308s)→ gpt-5.2-codex($0.33/346s)→ gpt-5.4($0.38/429s)→ gpt-5.2($0.4/415s)→ gpt-5.6-sol($0.57/364s)→ gpt-6-astra($0.87/391s)。
Anthropic(11 個):claude-3-haiku($0.002/13s)→ claude-4.5-haiku($0.012/12s)→ claude-4-sonnet($0.029/16s)→ claude-4.5-sonnet($0.034/25s)→ claude-4.5-opus($0.055/24s)→ claude-4-opus($0.088/21s)→ claude-4.1-opus($0.11/71s)→ claude-4.8-opus($0.46/222s)→ claude-4.6-opus($0.49/234s)→ claude-opus-5($0.5/275s)→ claude-fable-5.1($2.13/519s)。
DeepSeek(9 個):v3-0324($0.001/26s)→ v3.2($0.001/25s)→ v3.1-terminus($0.002/77s)→ r1-distill-llama-70b($0.002/107s)→ r1-0528($0.004/94s)→ v4-flash($0.007/450s)→ v4.1-flash($0.019/62s)→ v4-flash-vision-exp($0.021/51s)→ v4-pro($0.055/214s)。
旗艦跨提示詞欄:穩定不是偶然
同一模型在不同提示詞下的成本/耗時(抓取資料):
| 模型 | Pelican on a bike | Lighthouse at night | Penguin with umbrella | Pelican riding a bicycle |
|---|---|---|---|---|
| GPT-6 Astra | $0.87 / 391s | $0.74 / 971s | $0.91 / 947s | — |
| Claude Opus 5 | $0.5 / 275s | $0.57 / 277s | $0.83 / 379s | — |
| DeepSeek V4 Pro | $0.055 / 214s | $0.12 / 358s | — | $0.093 / 484s |
兩個讀法:一是成本跨欄穩定(同一模型的價格由推理深度決定,而非題目難度),二是 GPT-6 Astra 在「夜晚燈塔」上想了 971 秒——十六分鐘,把「思考的代價」四個字寫到了極致。
四張圖看懂「推理深度」的代價
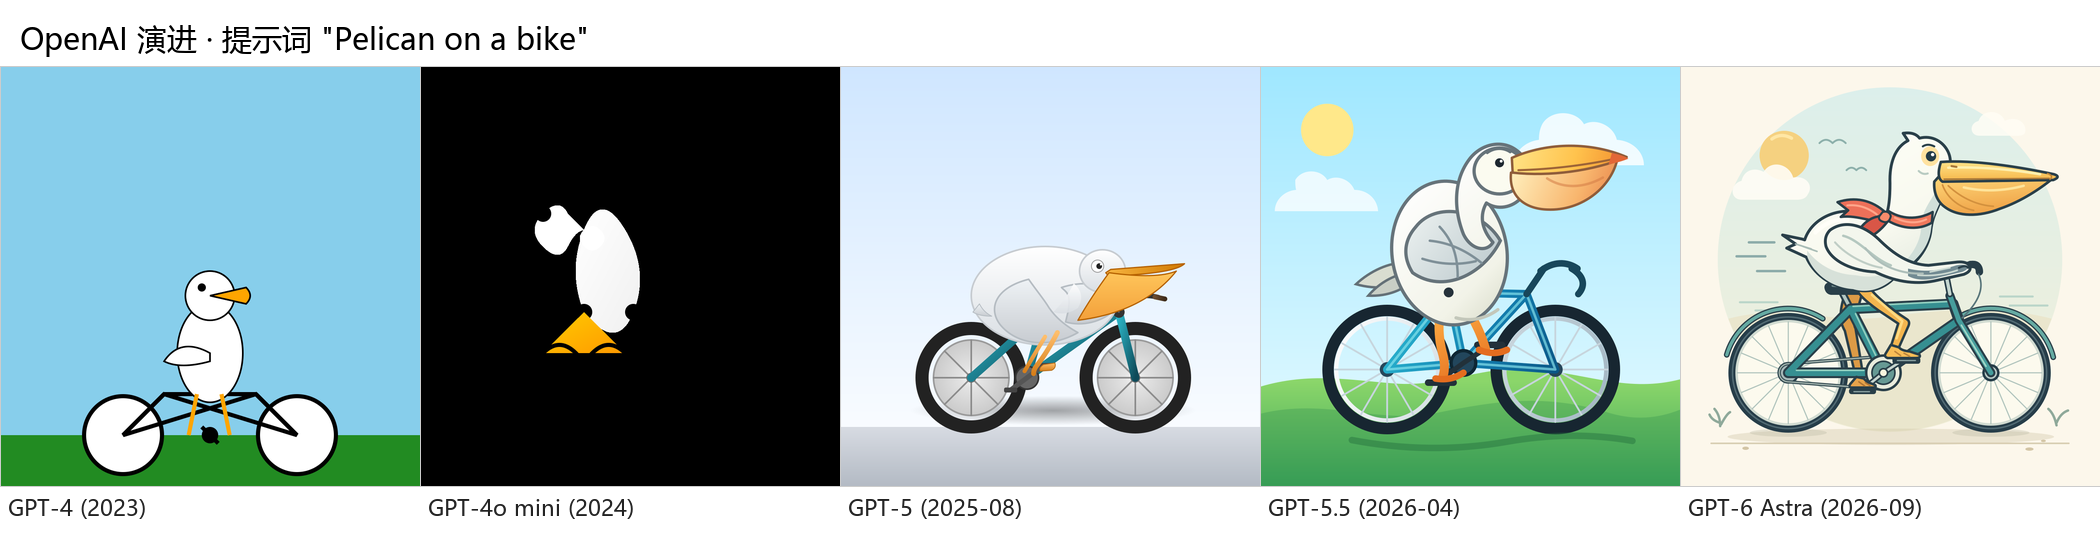
① OpenAI 線:從「簡筆畫」到「紅圍巾」。 GPT-4 畫的鵜鶘是極簡線條,幾筆交代完事;GPT-4o mini 畫面殘缺、背景發黑;GPT-5 形體完整、自行車結構清晰;GPT-5.5 有了太陽、雲、草地;到 GPT-6 Astra,鵜鶘戴上紅圍巾,背景有光暈和植被,完成度判若兩代。成本同步從 $0.043 漲到 $0.87(約 20 倍),耗時從 5 秒漲到 391 秒(約 78 倍)。多出來的每一分錢、每一秒,都花在「把畫面在腦子裡多過幾遍」上。
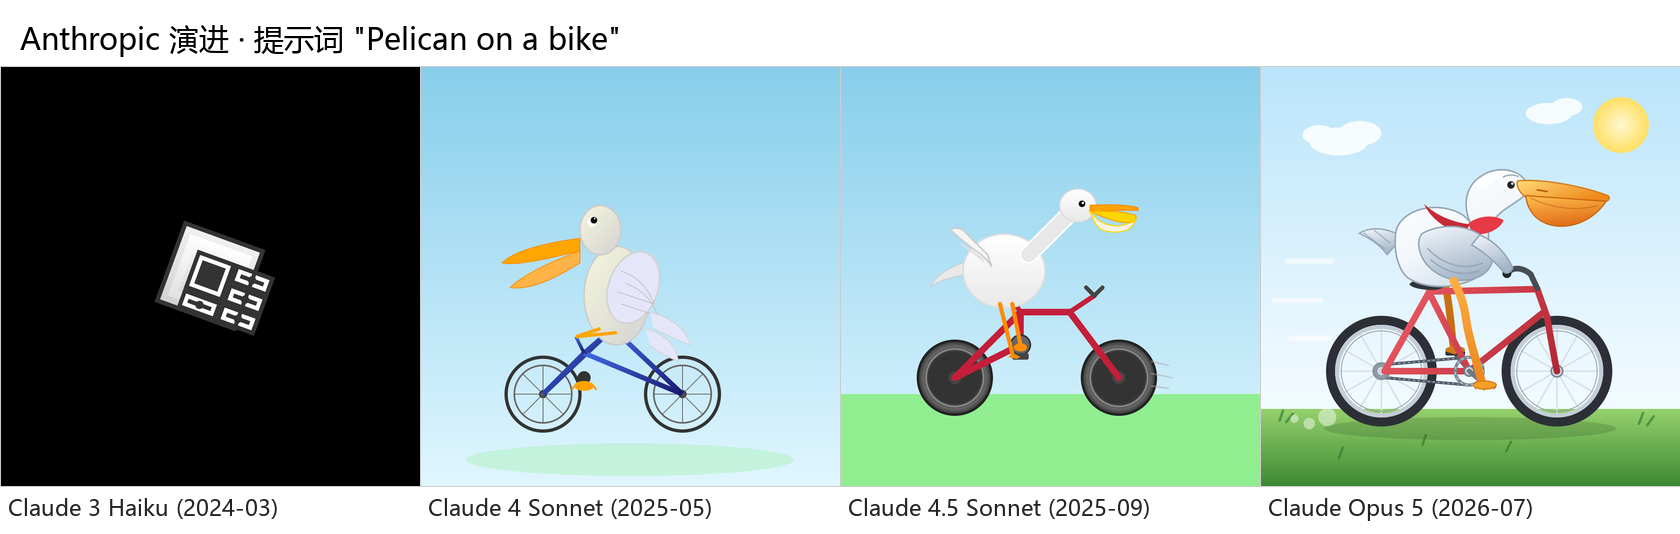
② Anthropic 線:從「沒畫出來」到「全場最貴」。 Claude 3 Haiku 在默認欄直接沒有產出有效畫面(樣張是佔位圖標);Claude 4 Sonnet 開始能畫出像樣的構圖;Opus 5 達到場景完整;到了 Fable 5.1,單次 $2.13、耗時 519 秒,是全榜最貴的一單——和它「自適應思考常開、默認 high effort」的產品設計完全一致:貴,但把「想多深」的選擇權交給運行時。
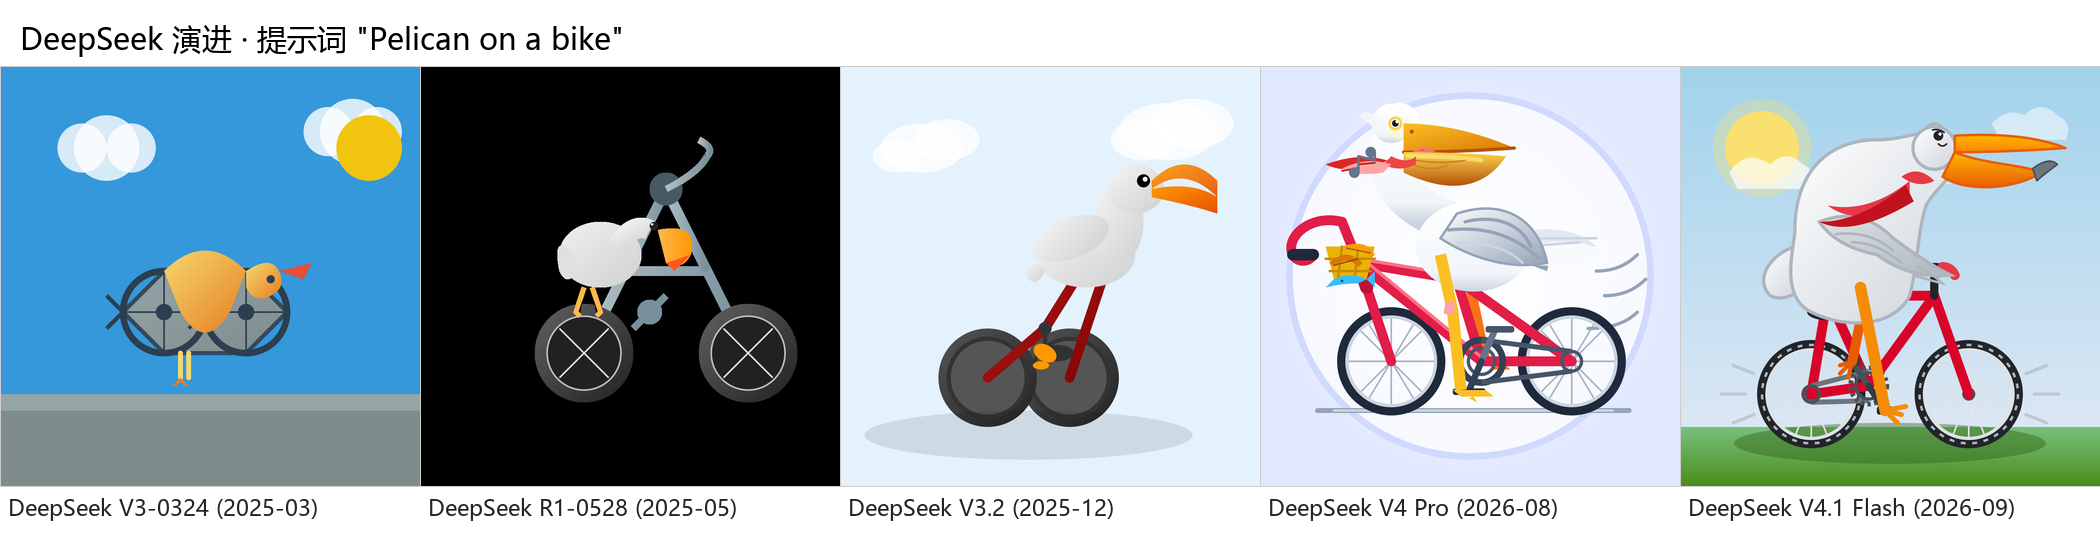
③ DeepSeek 線:貼著左下方的性價比曲線。 V3-0324 只要 $0.001、26 秒;R1-0528 畫出了帶場景的畫面,$0.004;V4 Pro 的畫面完成度直追頂級閉源,成本 $0.055——只有 GPT-6 Astra 的十六分之一、Fable 5.1 的三十九分之一。到 V4.1 Flash,$0.019、62 秒,是「便宜 + 快 + 畫面不差」三者最平衡的一個點。
④ Lighthouse 四旗艦:換個考題,差距依舊。 在「夜晚燈塔」這一題上:GPT-5.5 畫面簡單、細節稀疏($0.55/370s);GPT-6 Astra 用了 16 分鐘思考,畫面最完整($0.74/971s);Claude Opus 5 用不到 5 分鐘交出接近完成度的畫面($0.57/277s);DeepSeek V4 Pro 只花 $0.12、6 分鐘,完成度排在第二梯隊——**效率與質量的最優解,在這張圖上就是「越靠左下越好」
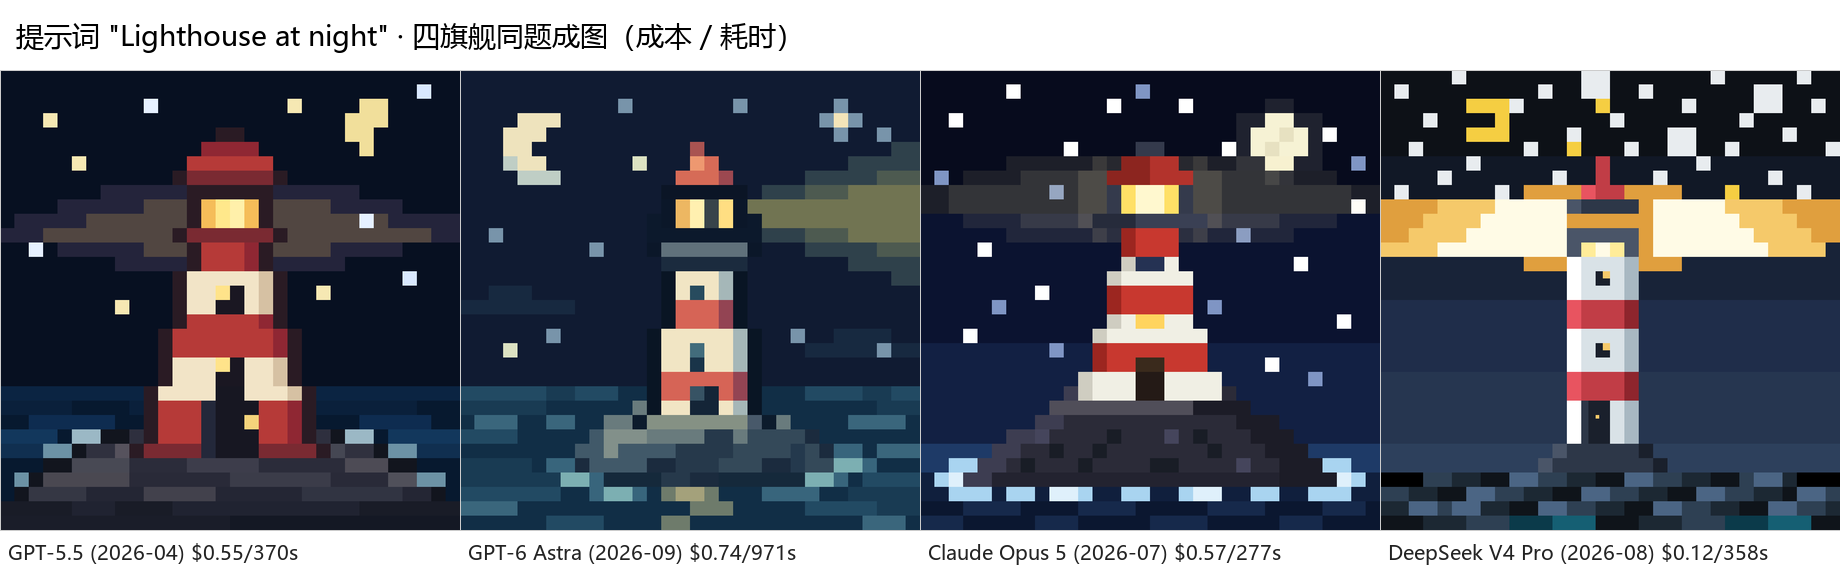 **。
三個反直覺的發現
- 最便宜的模型不是最強的,但也不是最差的。 全榜成本最低的五個模型全是小參數開源模型(Gemma 3 12B $0.00015、Llama 4 Scout 17B、Ministral 3B/8B、騰訊 hy-mt2 1.8B),畫面完成度肉眼可見地低——但它們證明「推理」和「生成成本」不是一回事:小模型可以又快又便宜地完成一次成圖,只是畫不出細節。
- 推理模型的競爭,從來不是「誰更便宜」。 旗艦們一個比一個貴(GPT-6 Astra $0.87、Fable 5.1 $2.13),因為買家買的不是「畫一張圖」,而是「畫一張好圖所必需的深度思考」。真正的競爭是「同樣的預算,誰的智能密度更高」。
- 榜單有「缺席者」,缺席本身就是信息。 截至快照(2026-10-04),最新一代的 Claude Opus 5.5 / Sonnet 5.5、GPT-6 Sol/Luna、DeepSeek V4.1 Pro 都還沒上欄——OpenRouter 收錄滯後於官方發佈。也就是說,這個榜的「天花板」時刻在刷新,但「推理成本隨時間推移只漲不跌」的長期趨勢已經寫死。
終章 三條路線,一個收斂方向
把 2024-09 到 2026-09 的三年攤開,三家的路線差異清晰得可以畫成三根箭頭:
- OpenAI:獨立 o 系列 → 統一 GPT 系統自動擋 → 能力層定價(Sol/Terra/Luna、Astra/6.1 Sol)。方向是能力集成與路由;
- Anthropic:單模型混合推理 → 自適應思考常開。始終拒絕「雙模型分裂」,方向是運行時自治與安全分級;
- DeepSeek:純 RL 開源 → 稀疏注意力降本 → 非對稱架構 + KV 緩存壓縮。方向是效率民主化。
但三條線在終點匯合,形成五個全行業共識:
- 推理 = 測試時計算,成本和耗時成為與能力並列的硬指標;
- 思考強度可調成為通用接口(OpenAI 的 effort、Claude 的 effort 五檔、DeepSeek 的 low/high/max 與連續 1–100);
- 模型路由與動態調整興起:系統/會話中自動決定「想多久」(Astra 支持對話中途調 effort、Fable 5.1 支持 per-message effort);
- 效率競賽升級為架構級競爭:從降價促銷(R1 的 1/30、Opus 4.5 的 -66%、V3.2 的 -50%)到架構重構(CED、CSA2、FP4 緩存、1M 上下文緩存命中 $0.003);
- 能力分級與安全治理成為並行的第二戰場:OpenAI 的「Critical」網絡能力分級與思維鏈監控、Anthropic 的安全分類器與受限訪問(Mythos/Project Glasswing)、DeepSeek 的 MIT 開源與自部署門檻(約 2000 張 GPU)。
對做內容、做工具、做遊戲的人來說,這句話的實用含義是:選模型不再只看榜單第一名,而是看「你的任務需要它想多久」。做美術概念圖、代碼 Agent、長文檔研究,選「貴但想得深」的旗艦;做高頻、低成本、確定性任務,選「便宜且快」的檔位,把省下的預算留給真正需要推理的場景。Sketch 榜這面鏡子照出的,正是這個正在發生的轉變:這一行已經從「比誰聰明」轉向「比誰的算力花得值」。
附錄
一、資料與方法
- 榜單:OpenRouter Sketch 榜(
openrouter.ai/benchmarks/media/sketch),多模態六榜之一,文本模型一次成圖、結果按圖像評分;本站經 NAS 上的 Halo「AI大模型排行榜」插件緩存抓取,抓取時間 2026-10-04。 - 口徑:默認提示詞欄「Pelican on a bike」共 143 個模型;該欄上游不給出質量分,主指標為單次成本(越低越好)與生成耗時(秒);未自行加權合成任何「質量總分」。
- 三家旗艦代際樣本為人工選取的代表性版本;完整 640 條資料見素材目錄
or-sketch-live-full.json,各家完整清單見正文。 - OpenRouter 資料按 CC BY 4.0 授權轉述;廠商發佈時間的官方口徑分別見 OpenAI / Anthropic / DeepSeek 官方發佈記錄與模型文檔。
二、三家完整迭代時間線
| 時間 | OpenAI | Anthropic | DeepSeek |
|---|---|---|---|
| 2024-09 | o1-preview / o1-mini(草莓) | — | — |
| 2024-12 | o1 正式版;o3 預告(ARC-AGI 87.5%) | — | DeepSeek-V3(MoE/MLA/FP8) |
| 2025-01 | o3-mini 上線(首個免費推理模型) | — | R1 / R1-Zero(純 RL 開源) |
| 2025-02 | — | Claude 3.7 Sonnet(首個混合推理) | — |
| 2025-03 | — | — | V3-0324 |
| 2025-04 | o3 正式 + o4-mini | — | — |
| 2025-05 | — | Claude Opus 4 / Sonnet 4(思考+工具) | R1-0528 |
| 2025-08 | GPT-5(統一系統 Auto/Thinking) | Opus 4.1 | V3.1(混合架構) |
| 2025-09 | GPT-5-Codex | Sonnet 4.5 | V3.1-Terminus;V3.2-Exp(稀疏注意力) |
| 2025-10 | — | Haiku 4.5 | — |
| 2025-11 | GPT-5.1 | Opus 4.5(effort 三檔,降價 66%) | — |
| 2025-12 | GPT-5.2 | — | V3.2(IMO/IOI 四金,思考融入工具) |
| 2026-01/02 | GPT-5.2/5.3-Codex | Opus 4.6(自適應思考) | — |
| 2026-03 | GPT-5.4 / 5.4-mini/nano | — | — |
| 2026-04 | GPT-5.5 | Opus 4.7(手動模式移除) | V4 系列(1M 上下文,開源) |
| 2026-05 | — | Opus 4.8(Dynamic Workflows) | — |
| 2026-06 | — | Fable 5 / Mythos 5(6-09);Sonnet 5(6-30) | — |
| 2026-07 | GPT-5.6(Sol/Terra/Luna) | Opus 5(7-23) | V4-Flash 正式版 |
| 2026-08 | — | — | V4-Pro 正式版;V4-Flash-Vision-Exp |
| 2026-09 | GPT-6 Astra(9-03);Sol/Luna(9-22);GPT-6.1 Sol(9-29) | Fable 5.1 / Mythos 5.1(9-01);Opus 5.5(9-22) | V4.1-Flash(9-10,新架構);V4 Pro 下線(9-14) |
三、主要 API 定價對照(每百萬 token,官方公開價)
| 模型 | 輸入 | 輸出 | 說明 |
|---|---|---|---|
| GPT-6 Astra | $10(緩存命中 $1) | $50 | 1.05M 上下文,128K 輸出 |
| GPT-6.1 Sol | $2 | $10 | 接近 Astra,多智能體 beta |
| Claude Fable 5.1 | $10(緩存讀取 $0.25) | $50 | 自適應思考常開,默認 high |
| Claude Opus 5.5 | $4 | $20 | 日常專業工作主力 |
| Claude Sonnet 5.5 | $2 | $10 | 速度與智能平衡 |
| Claude Haiku 4.5 | $1 | $5 | 最快檔 |
| DeepSeek V4.1 Flash(閒時) | $0.15(緩存命中 $0.003) | $0.6 | 峰谷定價,高峰翻倍;1M 上下文 |
| DeepSeek V4 Pro(下線前,閒時) | $0.66 | $1.98 | 2026-09-14 後路由至 V4.1-Flash |
四、術語表
- 思維鏈(CoT):模型在作答前生成的內部推理步驟;推理模型的核心機制。
- 測試時計算(test-time compute):推理階段投入的額外計算(思考 token);與「預訓練算力」「後訓練算力」並列為第三條縮放維度。
- RLVR:可驗證獎勵的強化學習——用客觀對錯(數學/代碼/競賽)而非人類偏好訓練推理。
- GRPO:群體相對策略優化,DeepSeek 的強化學習算法,省去 critic 模型,訓練成本更低。
- MoE(混合專家):大參數模型每次只激活部分參數,DeepSeek/開源路線的主流架構。
- MLA / DSA / CSA2:多頭潛在注意力 / 稀疏注意力 / 壓縮稀疏注意力——把注意力緩存做小做省的技術。
- effort / budget_tokens:思考強度 / 思考預算——控制「想多久」的兩個通用旋鈕。
- 自適應思考:模型自行決定思考深度(Claude 4.6 起,Fable 5.1 起常開)。
- 模型路由:系統按任務難度/成本自動分派模型檔位(GPT-5.6 的 Sol/Terra/Luna、GPT-6 家族)。