一张让模型画鹈鹕的排行榜,意外成了观察推理模型三年进化最好的窗口。
2024 年 9 月,OpenAI 发布 o1 时有个被反复引用的细节:它会在回答前「思考」10 到 20 秒,当时用户抱怨「像个打字很慢的学霸」。两年后,GPT-6 Astra 拿到「画一座夜晚灯塔」的考题时,可以「想」上整整 971 秒——十六分钟。这中间发生的事,不是简单的模型变强,而是整个行业对「智能」的定义方式变了:从「谁答得快」变成「谁肯多想、多想之后值不值」。
这篇文章用一条真实的横切面数据——OpenRouter Sketch 榜(让文本模型「一次成图」的画画榜单,2026-10-04 经 NAS 上的「AI大模型排行榜」插件抓取)——把 ChatGPT、Claude、DeepSeek 三家的推理模型发展路程完整串起来。你会发现:推理能力的每一次跃迁,都清清楚楚写在「成本」和「耗时」这两个数字上。
第〇章 先搞懂:推理模型到底「多做了什么」
在进入时间线之前,需要三分钟理解一个概念:推理模型和普通模型的区别,本质上是「把回答变成一次计算过程」。
普通 LLM 拿到问题直接生成答案,一个字接一个字往外吐。推理模型(reasoning model)多做了两件事:
- 思维链(Chain of Thought):在给出最终答案之前,先在心里生成一大段「思考过程」——拆解问题、尝试解法、自我检查、修正方向。o1 的「思考 10 秒」,工程上就是生成了几千个额外的思考 token。
- 强化学习(Reinforcement Learning with Verifiable Rewards, RLVR):训练时不再只靠人类偏好打分,而是用有明确对错的任务(数学题、代码测试、竞赛题)给模型的「思考过程」奖励,逼它学会把算力花在刀刃上。
这套组合催生了一个新词:测试时计算(test-time compute)。o1 的技术报告里有一张关键图:在推理任务上,模型的正确率(pass@1)会随着「思考时间/思考 token 预算」的增加单调上升——这等于把「推理」本身变成了一条新的缩放定律(scaling law)。预训练缩放定律说的是「数据越多模型越聪明」,测试时缩放定律说的是「想得越久,答得越准」。
于是整个行业出现了三个新的可调参数,它们是后面所有故事的主线:
- 思考强度(effort):低/中/高/最大,或多档数值,控制「想多深」;
- 思考预算(budget_tokens):给思维链设定 token 上限;
- 模型路由(routing):系统自动判断「这个问题该秒回还是该深想」。
「思考」从不可见的工程细节,变成了可以定价、可以调参、可以对比的商品维度。这就是为什么后面所有数字都围着「成本」和「耗时」转。
第一章 2024 年秋:o1 按下「思考」键
推理模型的真正元年是 2024 年。9 月 12 日,OpenAI 发布 o1-preview 与 o1-mini,内部代号「草莓」(Strawberry)。它和此前所有大模型的根本区别是:先把答案在心里过一遍,再开口。
当时官方给的数据:在 IMO 国际数学奥林匹克资格赛上拿到 83%(GPT-4o 只有 13%);物理、化学、生物博士级基准超过人类专家。代价同样肉眼可见——更慢、更贵,发布初期一周只能用 30 条消息,聊天体验被吐槽「像个打字很慢的学霸」。
o1 的技术意义在于验证了两件事:RLVR 可以规模化(用可验证奖励替代人类反馈,模型学会了自我纠错);测试时计算可以规模化(给模型更多思考 token,正确率就涨)。12 月 6 日,支持多模态的 o1 正式版上线。
12 月 20 日,o3 在 OpenAI「12 天活动」收官夜亮相:ARC-AGI 视觉推理拿到 87.5%(人类基线 85%),数学、GPQA 全面破纪录。ARC-AGI 这个榜单的特殊之处在于它测的是抽象推理——不给模型见过的题,所以「背题」没用,只能靠真推理。
但故事在这里拐了个弯。2025 年 2 月 13 日,奥特曼宣布:o3 不单独发布了。推理能力将直接并进 GPT-5,因为 o1/o3 这类「独立推理模型」要和 GPT 主系列合并成一个能自动切换思考与否的系统。o3-mini 成了 o 系列最后的独苗(2025-01-31 上线,ChatGPT 首次向免费用户开放推理模型)。
回头看,o1→o3 这一年的意义:推理第一次成为可定价、可量化的商品维度,「思考多久」从工程细节变成了产品参数;而「要不要把推理做成独立产品」的路线分歧,为后两年的行业格局埋下了伏笔。
第二章 2025 年 1 月:DeepSeek 用开源撕开价格口子
如果说 o1 是「推理模型的 iPhone」,那 DeepSeek-R1 就是「安卓」——开源、可部署、论文级透明。
先看底座。2024 年 12 月 26 日,DeepSeek-V3 发布:671B 总参数、37B 激活的 MoE 架构,配合多头潜在注意力(MLA)、FP8 低精度训练、多 token 预测(MTP),官方论文披露的训练成本约 560 万美元——这个数字当时让整个硅谷重新算了一遍「训练大模型到底要多少钱」。
2025 年 1 月 20 日,R1 与 R1-Zero 发布,直接把推理模型的价格体系打穿:
- R1-Zero:全程不用人工标注,纯靠强化学习(GRPO——群体相对策略优化,连 critic 价值模型都省了)把推理能力「长」出来。训练日志里出现了著名的「Aha Moment」——模型自己停下来反思:「等等,等等,这是个值得标记的顿悟时刻……让我重新评估一下这个解法。」
- R1:在数学、代码上达到 o1 水平,按发布时 API 定价折算,输出价格约是 o1 的 1/27~1/30。权重 MIT 协议开源,还顺手蒸馏出 Qwen、Llama 的小模型。
- 传播效应:上架 7 天登顶美国 App Store 免费榜,直接把「OpenAI 该降价了」写进全行业日程,全球 AI 芯片股一度剧烈波动。
R1 之后,DeepSeek 的迭代几乎是一路踩着 OpenAI 的路线图走的:
| 时间 | 版本 | 关键动作 |
|---|---|---|
| 2025-03 | V3-0324 | 推理增强,AIME 39.6→59.4 |
| 2025-05 | R1-0528 | AIME 70→87.5,GPQA 71.5→81 |
| 2025-08 | V3.1 | 一个模型同时支持思考/非思考双模式——和 GPT-5 的「统一系统」思路撞了个满怀 |
| 2025-09 | V3.2-Exp | 自研稀疏注意力(DSA),API 价格直接砍 50%+ |
| 2025-12 | V3.2 正式版 | 推理性能全球领先,拿下 IMO、CMO、ICPC、IOI 四块金牌,首次把「思考」融进工具调用(Agent) |
| 2026-04 | V4 系列 | Pro(1.6T 总参/49B 激活)与 Flash(285B/13B),百万 token 上下文标配,MIT 全开源 |
| 2026-08 | V4-Pro 正式版 | Agent 能力大幅增强(DeepSWE 62.7),原生支持 OpenAI Responses API,思考强度三档 low/high/max;官方评测称使用体验优于 Sonnet 4.5、交付质量接近 Opus 4.6 非思考模式 |
| 2026-09 | V4.1-Flash | 全新架构,见下 |
V4.1-Flash(2026-09-10)是 DeepSeek 效率路线的一座里程碑:
- 架构:全新 Causal Encoder-Decoder(因果编码器-解码器)非对称结构,552B 骨干参数(另有 196B 稀疏记忆模块),但 prefill 阶段每 token 只激活 8B、decode 阶段激活 16B——「读」和「写」用不同规模的计算,专为 Agent 这种「大量读入、少量产出」的工作形态设计;
- KV Cache 压缩:全局缓存压到 890 字节/token(约为 V4-Flash 的 1/4),相对初代模型缩小 437 倍——缓存小,长上下文和 Agent 多轮任务的成本就断崖式下降;
- 原生多模态:视觉理解并入主力模型(不再需要外挂 Vision 实验版),45T 多模态语料预训练;
- 成绩:GPQA Diamond 90.9、Codeforces 评级 3471、Terminal-Bench 2.1 90.6、DeepSWE v1.1 74.2、CyberGym 88.1、AutomationBench 54.8;
- 定价:API 改名 deepseek-flash,闲时缓存命中输入低至 $0.003/百万 token,缓存未命中 $0.15,输出 $0.6——比 V4-Flash 同档再降 60%。
还有一个值得记住的行业插曲:DeepSeek 宣布 2026-09-14 后 V4 Pro 下线、请求自动路由到 V4.1-Flash 并按 Flash 价格计费,官方理由是「继续以更高价、更慢速度提供更弱的 V4 Pro 已不合适」。社区反应两极:有人说「免费升级还降价」,有人说「我验证过的生产工作流被 48 小时通知强切了」(对比 OpenAI 关停 Sora API 给了 6 个月预告)。这件事说明:当「便宜」变成公司战略,连老用户的迁移成本都会被算进效率账本里。
DeepSeek 这条线的关键词始终是效率:别人用算力换智能,它用架构换智能——MoE 稀疏激活、注意力压缩、非对称输入输出、KV 缓存瘦身。它把「顶级推理」的单价一路打到了闭源模型的零头,也把「开源权重 + 论文透明」变成整个行业的定价锚。
第三章 Claude 的第三条路:混合推理 → 自适应思考
Anthropic 是三家里面唯一在 2024 年没有发推理模型的。CEO Dario Amodei 公开表态反对「快模型 / 推理模型」双产品分裂,认为让用户手动选「要不要思考」是交互设计的失败——这个立场直接决定了 Claude 之后三年的路线。
2025 年 2 月 24 日,Claude 3.7 Sonnet 带着 Extended Thinking(扩展思考) 出场,被定义为「市场首个混合推理模型」:同一个权重,既能秒回、也能深度思考,要不要想、想多久,交给 API 参数 budget_tokens 控制。这是对 o1 路线的正面反驳——不分裂产品,把选择权交给调用方。
后续演进都在打磨这个「思考开关」:
- 2025-05 Claude 4(Opus/Sonnet):思考期间能调用工具,还引入「思考摘要」机制(用小模型压缩思维链,降低成本和延迟);
- 2025-08 Opus 4.1:编码与长上下文提升;
- 2025-09/10 Sonnet 4.5 / Haiku 4.5:中端与入门档补位;
- 2025-11 Opus 4.5:新增 effort 低/中/高三档粗粒度控制,同时API 价格砍掉 66%($15/$75 → $5/$25)——推理模型的「贵」第一次被主动让利;
- 2026-02 Opus 4.6:自适应思考(adaptive thinking)——模型自己判断要不要想、想多深,手动模式开始弃用;
- 2026-04 Opus 4.7:手动模式彻底移除(返回 400),只留自适应 + xhigh 档;
- 2026-05 Opus 4.8:Dynamic Workflows(并行子智能体编排)。
2026 年夏天,Anthropic 进入第五代,产品线也从「版本号」变成「角色分工」:
- 2026-06-09 Fable 5 / Mythos 5:首个 Fable 级模型,主打长周期 Agent 工作(曾因美国出口管制在 6-12 短暂停服,7-01 恢复);
- 2026-06-30 Sonnet 5:$2/$10,速度与智能的平衡档;
- 2026-07-23 Opus 5:$5/$25,日常专业工作主力;
- 2026-09-01 Fable 5.1:自适应思考常开不可关闭(手动 disabled 直接 400),effort 五档(low/medium/high/xhigh/max,默认 high),1M 上下文、128K 输出,$10/$50,缓存读取降到 $0.25(比 Fable 5 便宜 75%,长 Agent 会话成本大降);同权重受限版 Mythos 5.1 只对通过审查的机构开放(网络安全/生物领域能力分级,类似 OpenAI 的受限访问);
- 2026-09-22 Opus 5.5($4/$20)与 Sonnet 5.5($2/$10)补齐产品线。
到 2026 年 10 月,Claude 的定价阶梯是:Haiku 4.5($1/$5)→ Sonnet 5.5($2/$10)→ Opus 5.5($4/$20)→ Fable 5.1($10/$50)。每一档对应一种「思考强度」:从「最快秒回」到「自适应常开、默认 high」。
Claude 路线的本质:推理不是开关,是运行时资源。从「开发者在代码里拧 token 预算」到「模型自己按任务难度分配算力」,再到「分类器把高风险的请求降级到低能力模型处理」——推理的门槛一路下沉,而安全分级成为并行演进的主题。
第四章 GPT-5 之后:推理变成「自动挡」
OpenAI 的回应是 2025 年 8 月 7 日的 GPT-5:o 系列正式并入 GPT 主系列,ChatGPT 不再让用户选模型,而是自动判断「该秒回还是该深想」——Auto 模式。GPT-5 的能力层覆盖编码、数学、写作、视觉,被视为「统一系统」的完成形态。
此后 OpenAI 进入高频小步快跑:
| 时间 | 版本 | 要点 |
|---|---|---|
| 2025-08 | GPT-5 / mini / nano | 统一系统,Auto/Thinking 双模式 |
| 2025-09 | GPT-5-Codex | 面向 Agent 编程的专属版本 |
| 2025-11 | GPT-5.1 | 编码与指令遵循增强 |
| 2025-12 | GPT-5.2 | 质量与工具调用提升 |
| 2026-01~02 | GPT-5.2/5.3-Codex | 编程 Agent 专项迭代 |
| 2026-03 | GPT-5.4 / 5.4-mini/nano | 性能与成本分层 |
| 2026-04 | GPT-5.5 | 低成本档性能逼近旗舰 |
| 2026-07 | GPT-5.6(Sol/Terra/Luna) | 能力层正式分三档定价:Sol(旗舰)> Terra > Luna(入门),按任务复杂度路由 |
| 2026-09-03 | GPT-6 Astra | 官方称「世界上最智能、最对齐的模型」,见下 |
| 2026-09-22 | GPT-6 Sol / Luna | 以不同能力×成本组合承接日常 |
| 2026-09-29 | GPT-6.1 Sol | 接近 Astra 能力,API 价格不到 Astra 一半($2/$10),并支持多智能体 beta |
GPT-6 Astra 是这段历史的当前终点(2026-09-03 发布,2026-09-22 前逐步放开全量):
- 规格:1.05M token 上下文窗口、128K 最大输出,知识截止 2026-04-30,API 定价 $10/百万输入、$50/百万输出(缓存命中 $1);
- 跑分(OpenAI 官方自测):FrontierMath Tier 4 达到 98%(已帮助解决多个长期未解的数学开放问题)、ARC-AGI-3 99.9%、ExploitBench 100%、Terminal-Bench 4.0 57.9%(对比 GPT-5.6 Sol 37.3%、Claude Fable 5.1 55.8%,且官方称单任务 API 成本分别低约 9% 与 63%)、GPQA Diamond 96.0%;
- 安全分级:首个在 OpenAI Preparedness Framework 下达到「Critical」网络能力级别的模型——能自主发现并利用未知漏洞,因此同步上线了更严的安全栈、思维链全程监控和「失配监控」(misalignment monitoring);
- 对齐:54,000 个内部 Codex 任务模拟中,高严重度失配信号约为 GPT-5.6 Sol 的一半;
- 交互:支持异步工具调用、任务中途改指令(mid-turn steering)、对话中途调 effort;最低 effort 档不再支持(Astra 不允许「完全不思考」)。
注意 OpenAI 这一段的两个趋势:模型命名从「版本号」变成「能力分层」(Sol/Terra/Luna、GPT-6 Astra/Sol/Luna/6.1 Sol),推理强度从「用户选」变成「系统路由 + 会话中动态调整」。推理能力本身,正在从卖点变成基础设施。
第五章 用 Sketch 榜给三代人拍张合影
上面是「官方叙事」,下面是「实测数据」。OpenRouter 的 Sketch 榜做了一件很妙的事:给几十上百个文本模型同一个提示词(「鹈鹕骑自行车」「夜晚的灯塔」「打伞的企鹅」……),让它们直接产出图像。文本模型没有专门的图像模型那么强,但这个任务对「理解、规划、细节执行力」的综合要求,恰好是推理能力的试金石——而且它给每个模型都留下了可看的成品。
数据口径(抓取于 2026-10-04,经 NAS 上 Halo「AI大模型排行榜」插件抓取缓存)
- 全榜 4 个提示词栏共 640 条「模型 × 样张」记录,去重 204 个模型;默认栏「Pelican on a bike」参评 143 个模型(lighthouse 栏 173 个,全站最多);
- 该栏上游不给出质量分,主指标为单次成本(USD,越低越好)与生成耗时(秒);本文未自行加权合成任何「质量总分」;
- 全榜成本中位数约 $0.009~0.014、耗时中位数约 52~79 秒——也就是说,一次成图的「市场均价」非常便宜,贵出来的钱全花在「思考」上。
三家旗舰代际的「成本 × 耗时」对照(默认栏)
| 厂商 | 代际(发布时间) | 单次成本 | 生成耗时 |
|---|---|---|---|
| OpenAI | GPT-4(2023-03) | $0.043 | 5 秒 |
| OpenAI | GPT-4o mini(2024-07) | $0.00035 | 8 秒 |
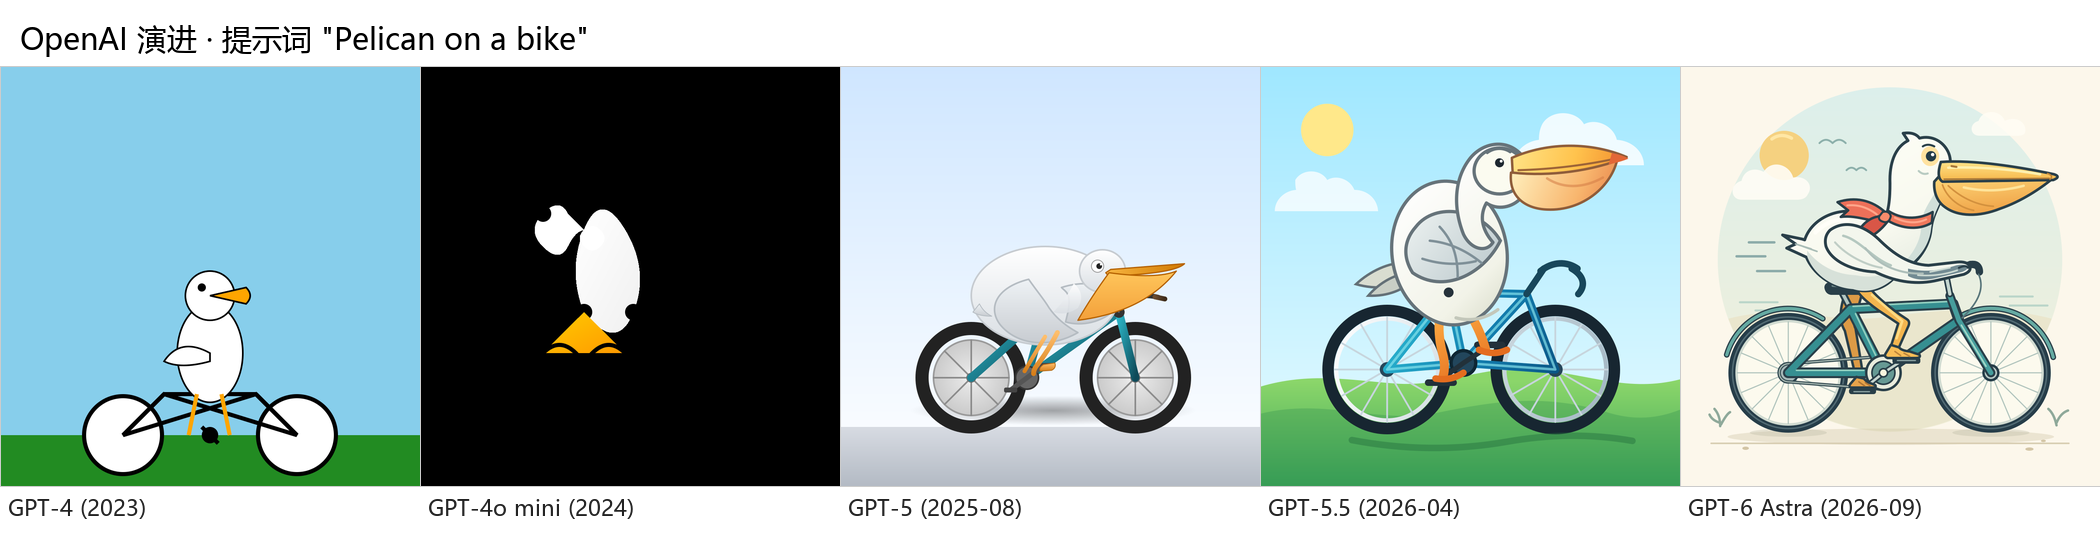
| OpenAI | GPT-5(2025-08) | $0.099 | 106 秒 |
| OpenAI | GPT-5.5(2026-04) | $0.15 | 69 秒 |
| OpenAI | GPT-6 Astra(2026-09) | $0.87 | 391 秒 |
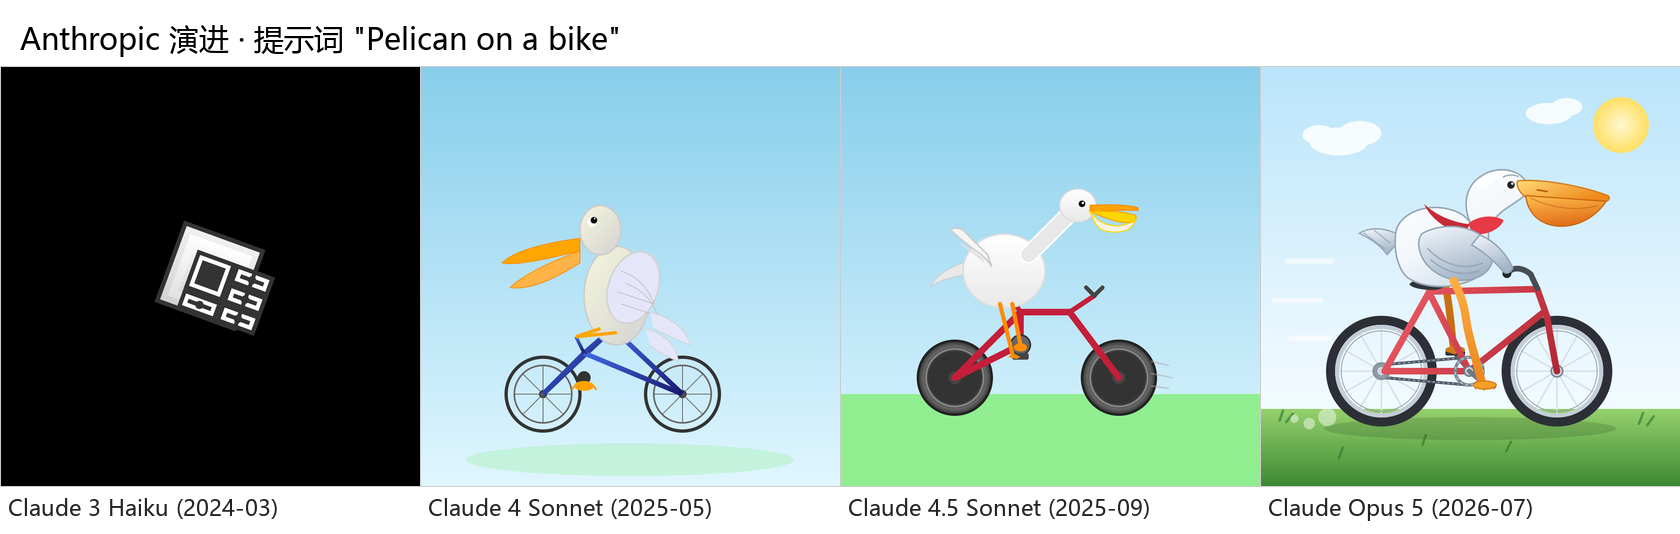
| Anthropic | Claude 3 Haiku(2024-03) | $0.002 | 13 秒 |
| Anthropic | Claude 4 Sonnet(2025-05) | $0.029 | 16 秒 |
| Anthropic | Claude 4.5 Sonnet(2025-09) | $0.034 | 25 秒 |
| Anthropic | Claude Opus 5(2026-07) | $0.5 | 275 秒 |
| Anthropic | Claude Fable 5.1(2026-09) | $2.13 | 519 秒 |
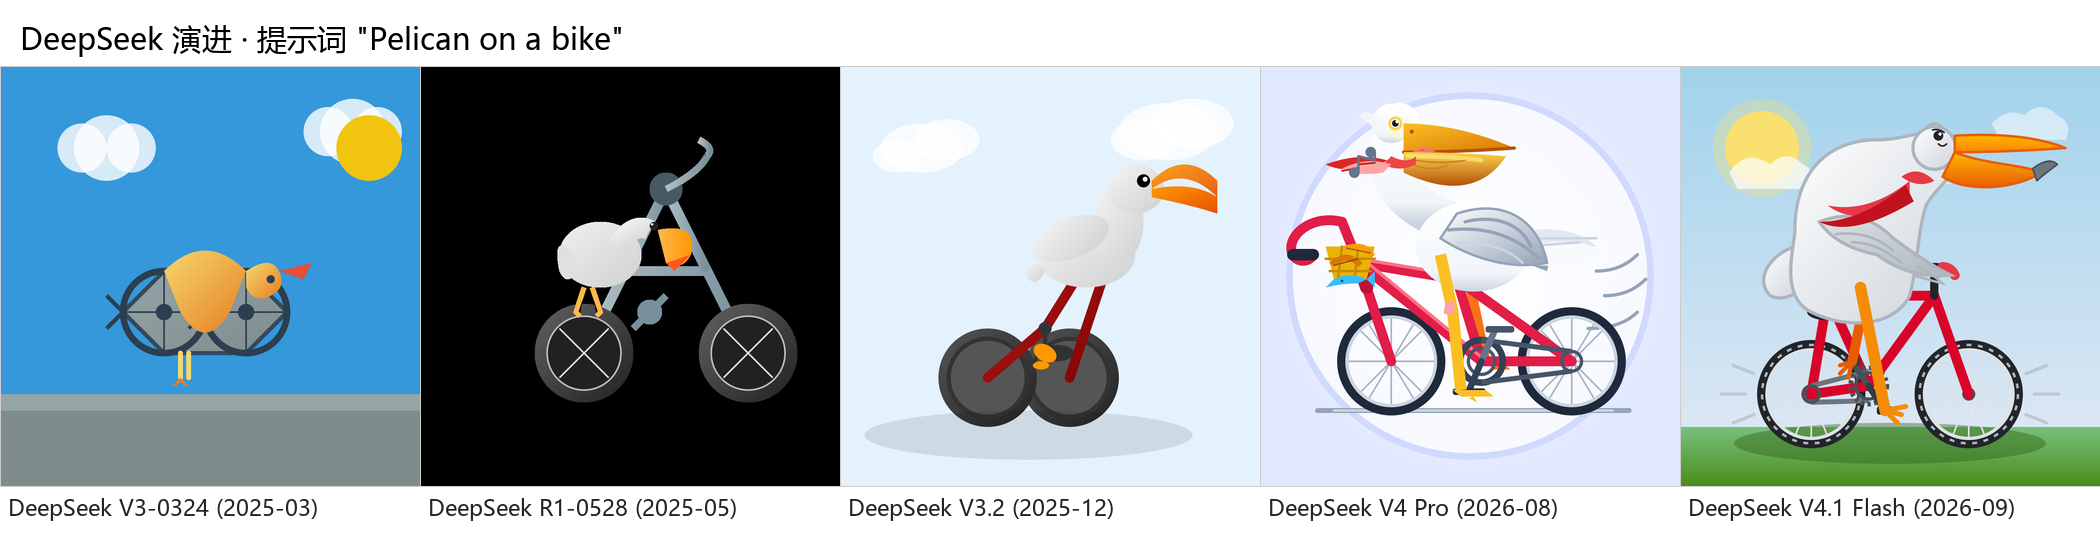
| DeepSeek | V3-0324(2025-03) | $0.001 | 26 秒 |
| DeepSeek | R1-0528(2025-05) | $0.004 | 94 秒 |
| DeepSeek | V3.2(2025-12) | $0.001 | 25 秒 |
| DeepSeek | V4 Pro(2026-08) | $0.055 | 214 秒 |
| DeepSeek | V4.1 Flash(2026-09) | $0.019 | 62 秒 |
来源:OpenRouter Sketch 榜(openrouter.ai/benchmarks/media/sketch,默认提示词栏),2026-10-04 抓取;OpenRouter 数据按 CC BY 4.0 授权转述。完整清单见下节。
三家族在默认栏的完整清单
把三家在默认栏所有参评模型摊开,演化脉络更完整(按成本升序):
OpenAI(20 个):gpt-4.1-nano($0.00027/7s)→ gpt-4o-mini($0.00035/8s)→ gpt-oss-120b($0.00065/40s)→ gpt-5-nano($0.01/144s)→ gpt-4.1($0.017/24s)→ gpt-5.1-codex($0.018/14s)→ gpt-5.1-codex-mini($0.019/171s)→ gpt-5-mini($0.025/100s)→ gpt-5.6-luna($0.032/263s)→ gpt-4($0.043/5s)→ gpt-5($0.099/106s)→ gpt-5.1($0.11/101s)→ gpt-5.5($0.15/69s)→ gpt-5.3-codex($0.21/156s)→ gpt-5.6-terra($0.29/308s)→ gpt-5.2-codex($0.33/346s)→ gpt-5.4($0.38/429s)→ gpt-5.2($0.4/415s)→ gpt-5.6-sol($0.57/364s)→ gpt-6-astra($0.87/391s)。
Anthropic(11 个):claude-3-haiku($0.002/13s)→ claude-4.5-haiku($0.012/12s)→ claude-4-sonnet($0.029/16s)→ claude-4.5-sonnet($0.034/25s)→ claude-4.5-opus($0.055/24s)→ claude-4-opus($0.088/21s)→ claude-4.1-opus($0.11/71s)→ claude-4.8-opus($0.46/222s)→ claude-4.6-opus($0.49/234s)→ claude-opus-5($0.5/275s)→ claude-fable-5.1($2.13/519s)。
DeepSeek(9 个):v3-0324($0.001/26s)→ v3.2($0.001/25s)→ v3.1-terminus($0.002/77s)→ r1-distill-llama-70b($0.002/107s)→ r1-0528($0.004/94s)→ v4-flash($0.007/450s)→ v4.1-flash($0.019/62s)→ v4-flash-vision-exp($0.021/51s)→ v4-pro($0.055/214s)。
旗舰跨提示词栏:稳定不是偶然
同一模型在不同提示词下的成本/耗时(抓取数据):
| 模型 | Pelican on a bike | Lighthouse at night | Penguin with umbrella | Pelican riding a bicycle |
|---|---|---|---|---|
| GPT-6 Astra | $0.87 / 391s | $0.74 / 971s | $0.91 / 947s | — |
| Claude Opus 5 | $0.5 / 275s | $0.57 / 277s | $0.83 / 379s | — |
| DeepSeek V4 Pro | $0.055 / 214s | $0.12 / 358s | — | $0.093 / 484s |
两个读法:一是成本跨栏稳定(同一模型的价格由推理深度决定,而非题目难度),二是 GPT-6 Astra 在「夜晚灯塔」上想了 971 秒——十六分钟,把「思考的代价」四个字写到了极致。
四张图看懂「推理深度」的代价
① OpenAI 线:从「简笔画」到「红围巾」。 GPT-4 画的鹈鹕是极简线条,几笔交代完事;GPT-4o mini 画面残缺、背景发黑;GPT-5 形体完整、自行车结构清晰;GPT-5.5 有了太阳、云、草地;到 GPT-6 Astra,鹈鹕戴上红围巾,背景有光晕和植被,完成度判若两代。成本同步从 $0.043 涨到 $0.87(约 20 倍),耗时从 5 秒涨到 391 秒(约 78 倍)。多出来的每一分钱、每一秒,都花在「把画面在脑子里多过几遍」上。
② Anthropic 线:从「没画出来」到「全场最贵」。 Claude 3 Haiku 在默认栏直接没有产出有效画面(样张是占位图标);Claude 4 Sonnet 开始能画出像样的构图;Opus 5 达到场景完整;到了 Fable 5.1,单次 $2.13、耗时 519 秒,是全榜最贵的一单——和它「自适应思考常开、默认 high effort」的产品设计完全一致:贵,但把「想多深」的选择权交给运行时。
③ DeepSeek 线:贴着左下方的性价比曲线。 V3-0324 只要 $0.001、26 秒;R1-0528 画出了带场景的画面,$0.004;V4 Pro 的画面完成度直追顶级闭源,成本 $0.055——只有 GPT-6 Astra 的十六分之一、Fable 5.1 的三十九分之一。到 V4.1 Flash,$0.019、62 秒,是「便宜 + 快 + 画面不差」三者最平衡的一个点。
④ Lighthouse 四旗舰:换个考题,差距依旧。 在「夜晚灯塔」这一题上:GPT-5.5 画面简单、细节稀疏($0.55/370s);GPT-6 Astra 用了 16 分钟思考,画面最完整($0.74/971s);Claude Opus 5 用不到 5 分钟交出接近完成度的画面($0.57/277s);DeepSeek V4 Pro 只花 $0.12、6 分钟,完成度排在第二梯队——**效率与质量的最优解,在这张图上就是「越靠左下越好」
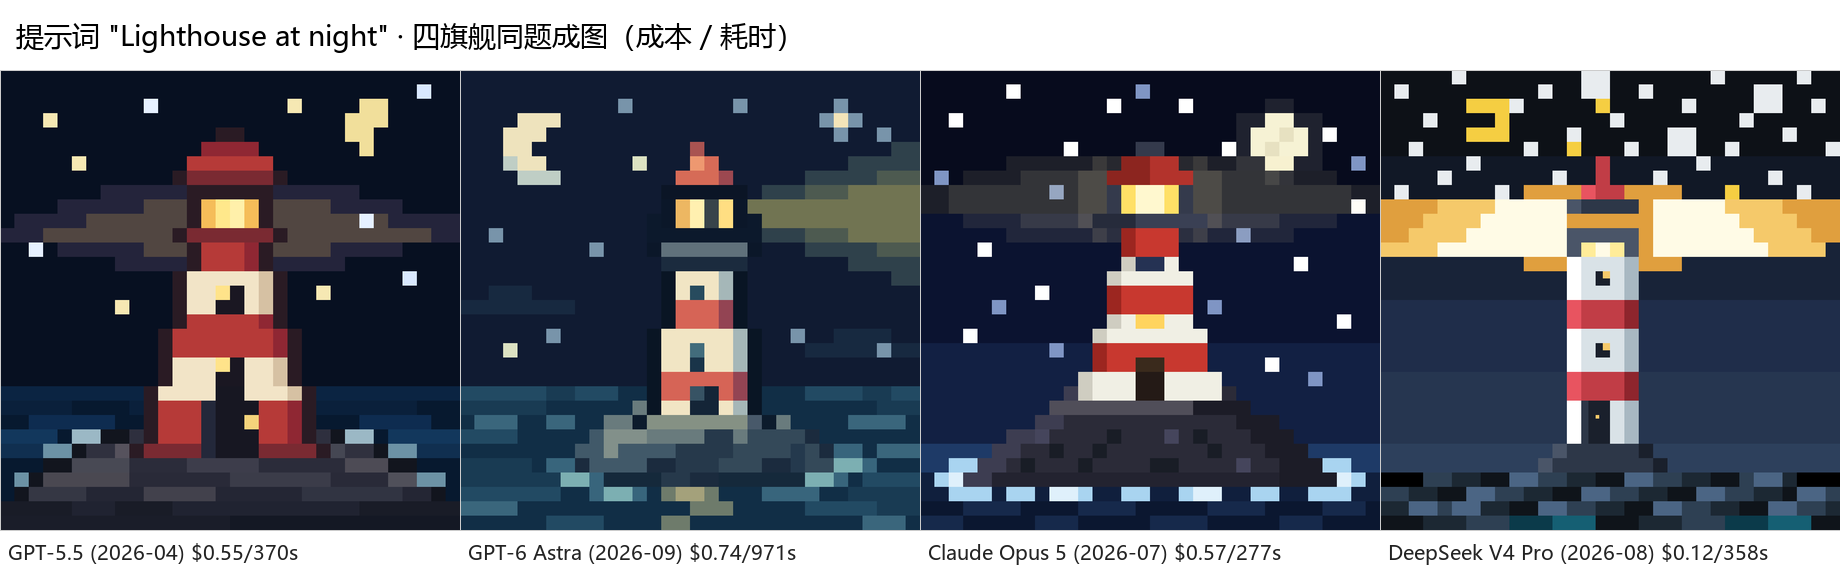 **。
三个反直觉的发现
- 最便宜的模型不是最强的,但也不是最差的。 全榜成本最低的五个模型全是小参数开源模型(Gemma 3 12B $0.00015、Llama 4 Scout 17B、Ministral 3B/8B、腾讯 hy-mt2 1.8B),画面完成度肉眼可见地低——但它们证明「推理」和「生成成本」不是一回事:小模型可以又快又便宜地完成一次成图,只是画不出细节。
- 推理模型的竞争,从来不是「谁更便宜」。 旗舰们一个比一个贵(GPT-6 Astra $0.87、Fable 5.1 $2.13),因为买家买的不是「画一张图」,而是「画一张好图所必需的深度思考」。真正的竞争是「同样的预算,谁的智能密度更高」。
- 榜单有「缺席者」,缺席本身就是信息。 截至快照(2026-10-04),最新一代的 Claude Opus 5.5 / Sonnet 5.5、GPT-6 Sol/Luna、DeepSeek V4.1 Pro 都还没上栏——OpenRouter 收录滞后于官方发布。也就是说,这个榜的「天花板」时刻在刷新,但「推理成本随时间推移只涨不跌」的长期趋势已经写死。
终章 三条路线,一个收敛方向
把 2024-09 到 2026-09 的三年摊开,三家的路线差异清晰得可以画成三根箭头:
- OpenAI:独立 o 系列 → 统一 GPT 系统自动挡 → 能力层定价(Sol/Terra/Luna、Astra/6.1 Sol)。方向是能力集成与路由;
- Anthropic:单模型混合推理 → 自适应思考常开。始终拒绝「双模型分裂」,方向是运行时自治与安全分级;
- DeepSeek:纯 RL 开源 → 稀疏注意力降本 → 非对称架构 + KV 缓存压缩。方向是效率民主化。
但三条线在终点汇合,形成五个全行业共识:
- 推理 = 测试时计算,成本和耗时成为与能力并列的硬指标;
- 思考强度可调成为通用接口(OpenAI 的 effort、Claude 的 effort 五档、DeepSeek 的 low/high/max 与连续 1–100);
- 模型路由与动态调整兴起:系统/会话中自动决定「想多久」(Astra 支持对话中途调 effort、Fable 5.1 支持 per-message effort);
- 效率竞赛升级为架构级竞争:从降价促销(R1 的 1/30、Opus 4.5 的 -66%、V3.2 的 -50%)到架构重构(CED、CSA2、FP4 缓存、1M 上下文缓存命中 $0.003);
- 能力分级与安全治理成为并行的第二战场:OpenAI 的「Critical」网络能力分级与思维链监控、Anthropic 的安全分类器与受限访问(Mythos/Project Glasswing)、DeepSeek 的 MIT 开源与自部署门槛(约 2000 张 GPU)。
对做内容、做工具、做游戏的人来说,这句话的实用含义是:选模型不再只看榜单第一名,而是看「你的任务需要它想多久」。做美术概念图、代码 Agent、长文档研究,选「贵但想得深」的旗舰;做高频、低成本、确定性任务,选「便宜且快」的档位,把省下的预算留给真正需要推理的场景。Sketch 榜这面镜子照出的,正是这个正在发生的转变:这一行已经从「比谁聪明」转向「比谁的算力花得值」。
附录
一、数据与方法
- 榜单:OpenRouter Sketch 榜(
openrouter.ai/benchmarks/media/sketch),多模态六榜之一,文本模型一次成图、结果按图像评分;本站经 NAS 上的 Halo「AI大模型排行榜」插件缓存抓取,抓取时间 2026-10-04。 - 口径:默认提示词栏「Pelican on a bike」共 143 个模型;该栏上游不给出质量分,主指标为单次成本(越低越好)与生成耗时(秒);未自行加权合成任何「质量总分」。
- 三家旗舰代际样本为人工选取的代表性版本;完整 640 条数据见素材目录
or-sketch-live-full.json,各家完整清单见正文。 - OpenRouter 数据按 CC BY 4.0 授权转述;厂商发布时间的官方口径分别见 OpenAI / Anthropic / DeepSeek 官方发布记录与模型文档。
二、三家完整迭代时间线
| 时间 | OpenAI | Anthropic | DeepSeek |
|---|---|---|---|
| 2024-09 | o1-preview / o1-mini(草莓) | — | — |
| 2024-12 | o1 正式版;o3 预告(ARC-AGI 87.5%) | — | DeepSeek-V3(MoE/MLA/FP8) |
| 2025-01 | o3-mini 上线(首个免费推理模型) | — | R1 / R1-Zero(纯 RL 开源) |
| 2025-02 | — | Claude 3.7 Sonnet(首个混合推理) | — |
| 2025-03 | — | — | V3-0324 |
| 2025-04 | o3 正式 + o4-mini | — | — |
| 2025-05 | — | Claude Opus 4 / Sonnet 4(思考+工具) | R1-0528 |
| 2025-08 | GPT-5(统一系统 Auto/Thinking) | Opus 4.1 | V3.1(混合架构) |
| 2025-09 | GPT-5-Codex | Sonnet 4.5 | V3.1-Terminus;V3.2-Exp(稀疏注意力) |
| 2025-10 | — | Haiku 4.5 | — |
| 2025-11 | GPT-5.1 | Opus 4.5(effort 三档,降价 66%) | — |
| 2025-12 | GPT-5.2 | — | V3.2(IMO/IOI 四金,思考融入工具) |
| 2026-01/02 | GPT-5.2/5.3-Codex | Opus 4.6(自适应思考) | — |
| 2026-03 | GPT-5.4 / 5.4-mini/nano | — | — |
| 2026-04 | GPT-5.5 | Opus 4.7(手动模式移除) | V4 系列(1M 上下文,开源) |
| 2026-05 | — | Opus 4.8(Dynamic Workflows) | — |
| 2026-06 | — | Fable 5 / Mythos 5(6-09);Sonnet 5(6-30) | — |
| 2026-07 | GPT-5.6(Sol/Terra/Luna) | Opus 5(7-23) | V4-Flash 正式版 |
| 2026-08 | — | — | V4-Pro 正式版;V4-Flash-Vision-Exp |
| 2026-09 | GPT-6 Astra(9-03);Sol/Luna(9-22);GPT-6.1 Sol(9-29) | Fable 5.1 / Mythos 5.1(9-01);Opus 5.5(9-22) | V4.1-Flash(9-10,新架构);V4 Pro 下线(9-14) |
三、主要 API 定价对照(每百万 token,官方公开价)
| 模型 | 输入 | 输出 | 说明 |
|---|---|---|---|
| GPT-6 Astra | $10(缓存命中 $1) | $50 | 1.05M 上下文,128K 输出 |
| GPT-6.1 Sol | $2 | $10 | 接近 Astra,多智能体 beta |
| Claude Fable 5.1 | $10(缓存读取 $0.25) | $50 | 自适应思考常开,默认 high |
| Claude Opus 5.5 | $4 | $20 | 日常专业工作主力 |
| Claude Sonnet 5.5 | $2 | $10 | 速度与智能平衡 |
| Claude Haiku 4.5 | $1 | $5 | 最快档 |
| DeepSeek V4.1 Flash(闲时) | $0.15(缓存命中 $0.003) | $0.6 | 峰谷定价,高峰翻倍;1M 上下文 |
| DeepSeek V4 Pro(下线前,闲时) | $0.66 | $1.98 | 2026-09-14 后路由至 V4.1-Flash |
四、术语表
- 思维链(CoT):模型在作答前生成的内部推理步骤;推理模型的核心机制。
- 测试时计算(test-time compute):推理阶段投入的额外计算(思考 token);与「预训练算力」「后训练算力」并列为第三条缩放维度。
- RLVR:可验证奖励的强化学习——用客观对错(数学/代码/竞赛)而非人类偏好训练推理。
- GRPO:群体相对策略优化,DeepSeek 的强化学习算法,省去 critic 模型,训练成本更低。
- MoE(混合专家):大参数模型每次只激活部分参数,DeepSeek/开源路线的主流架构。
- MLA / DSA / CSA2:多头潜在注意力 / 稀疏注意力 / 压缩稀疏注意力——把注意力缓存做小做省的技术。
- effort / budget_tokens:思考强度 / 思考预算——控制「想多久」的两个通用旋钮。
- 自适应思考:模型自行决定思考深度(Claude 4.6 起,Fable 5.1 起常开)。
- 模型路由:系统按任务难度/成本自动分派模型档位(GPT-5.6 的 Sol/Terra/Luna、GPT-6 家族)。