一个在 r/StableDiffusion 被反复问起的问题:为什么同一个 prompt,OpenAI 和 Midjourney 出来的是电影,Qwen 出来的是电商详情页?
答案不是"模型菜"。是你把一台精密机床,当菜刀用了。
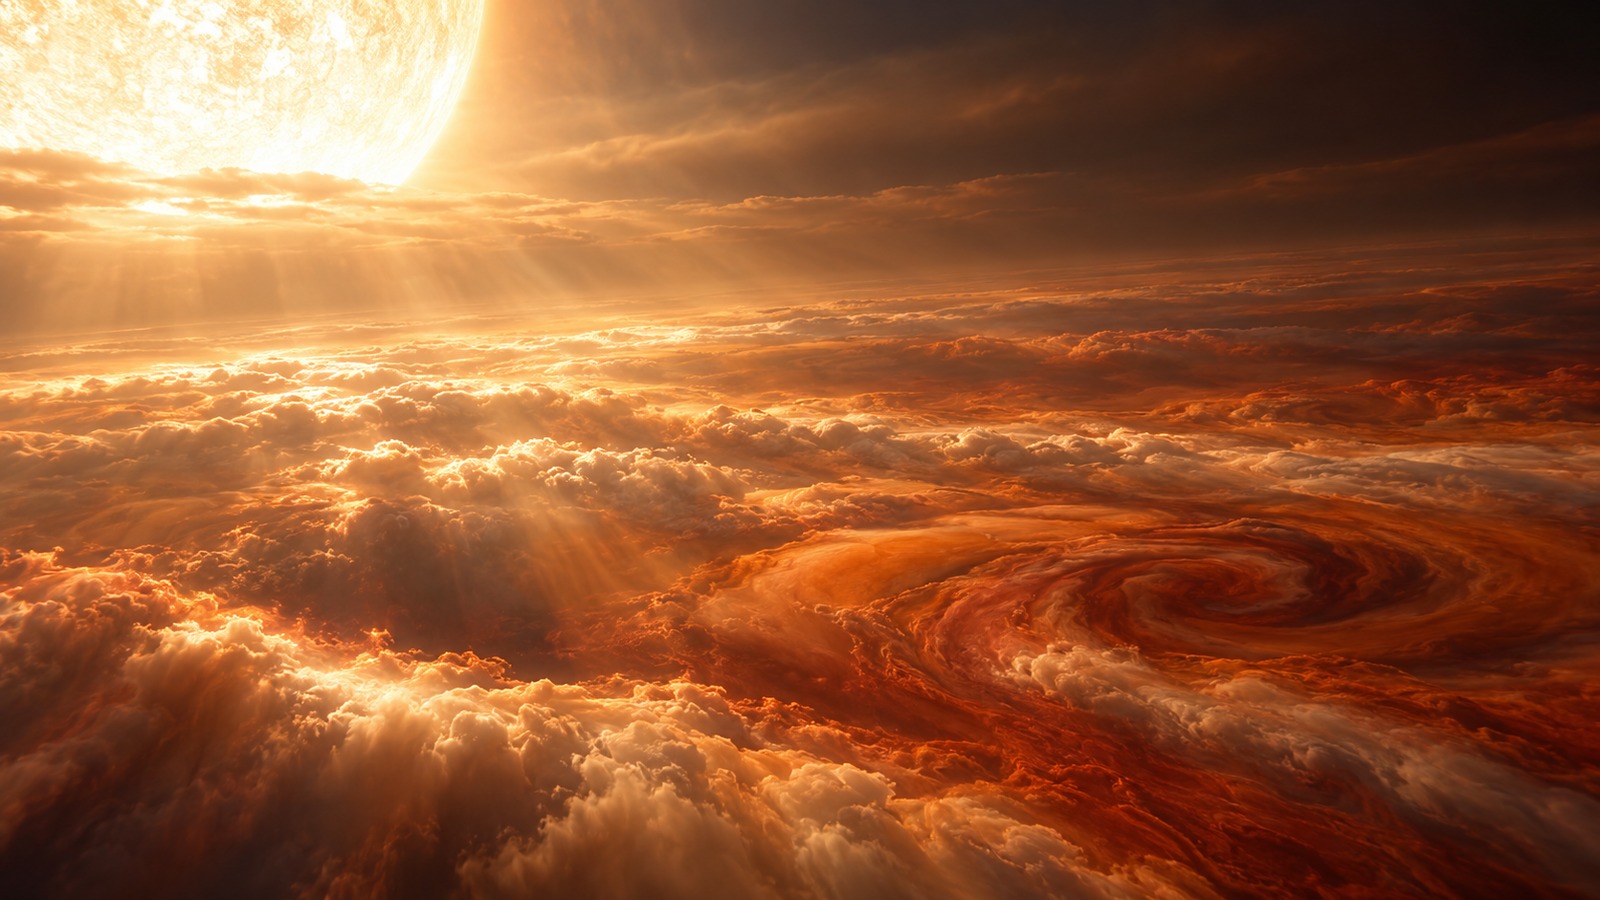
先看原帖里最直观的一组对比。同一段 prompt——一颗热木星上层大气、F 型次巨星悬在天空、24mm 广角、体积光——原帖作者用两个模型各出了一张。先是 OpenAI 的那张:
同一段 prompt,换 Qwen Image 2.1 在本地 ComfyUI 跑出来是这样:
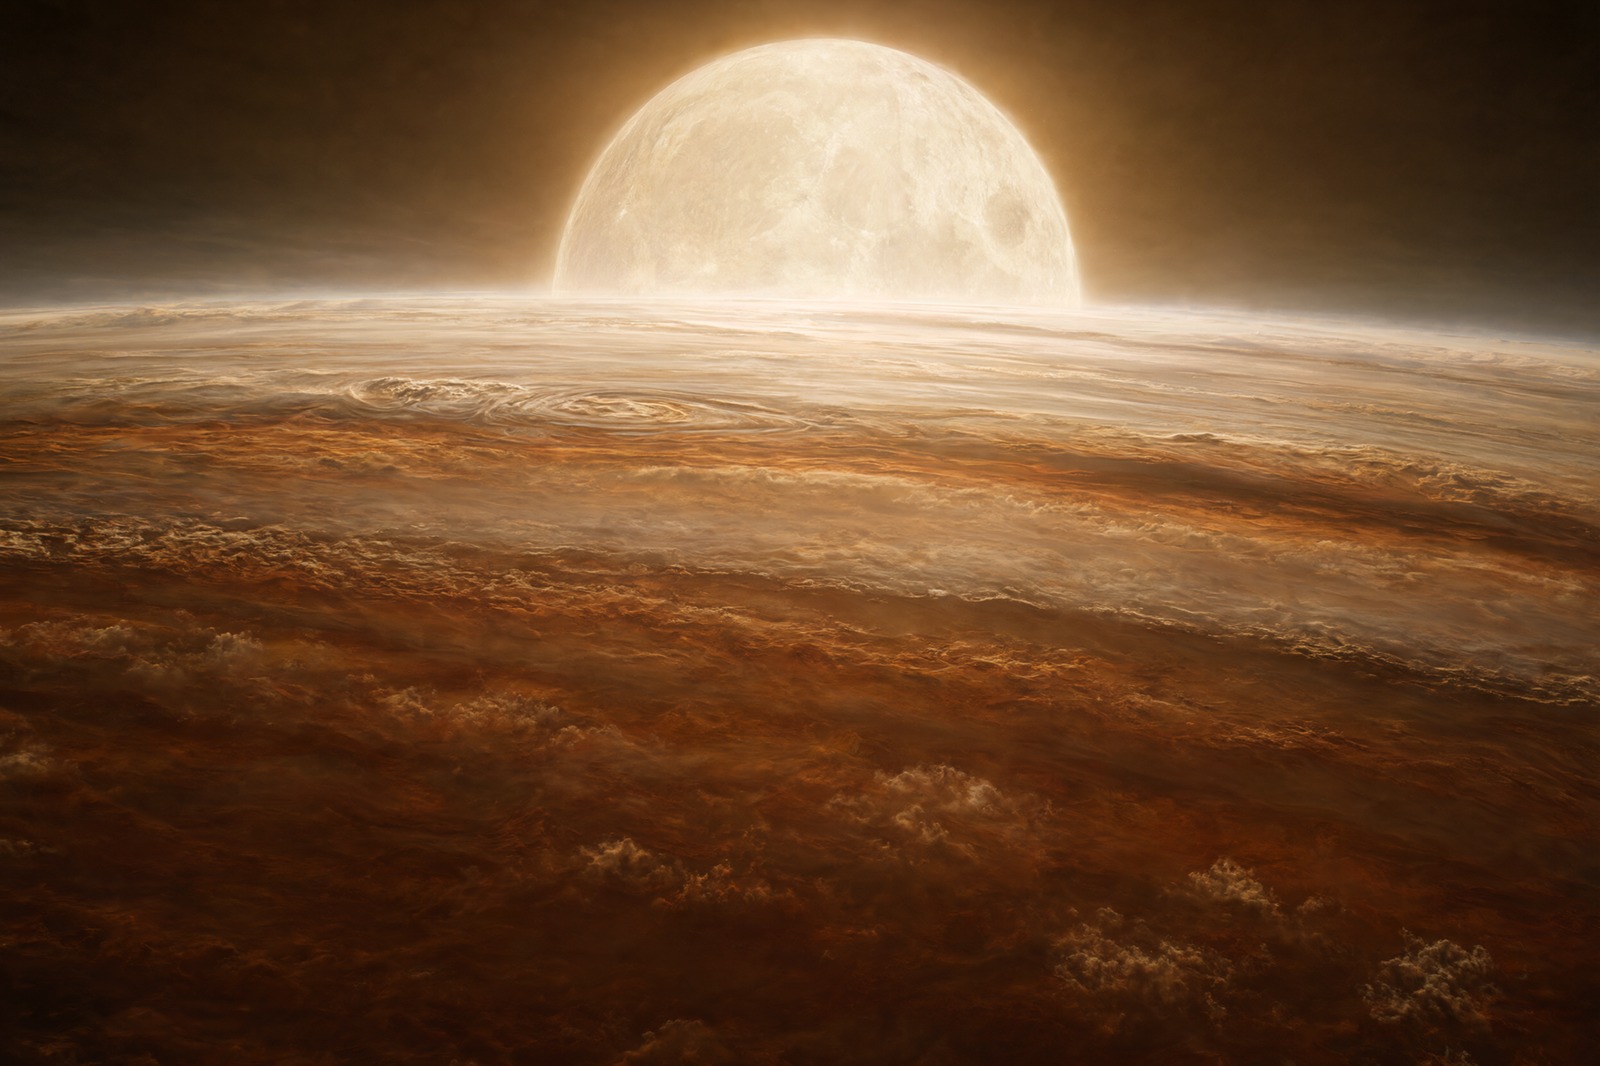
注意 Qwen 那张——它其实什么都没画错。热木星大气在,F 型次巨星在,24mm 广角边缘那点畸变也在。元素一个不落,可你就是觉得它像一张壁纸,而不是一张照片。
Qwen 不是不会画画,它是太听话了
打开 Qwen Image 2.1 的模型卡,第一行写的就是 instruction-following。这六个字是夸奖,也是诅咒。
你给它写一段三千字的 prompt——热木星上层大气、F 型次巨星三十度视直径、24mm 广角边缘畸变、体积光、琥珀色云层横带——它会一个不落地全部画进去。每一个词都在,每一个细节都到位。然后你盯着图看三秒,觉得寡淡。
问题不在它画了什么,在于它不敢删任何东西。
Midjourney 和 OpenAI 干的第一件事,是替你做减法。十个云层细节砍掉七个,剩下三个往死里画;边角压暗,主光打亮,把你 prompt 里那个"探测器视角"真的做成一个有重量的视角,而不是"我写了探测器这三个字"。
这不是技术差距,是产品哲学的分野。Midjourney 卖的是"哇塞",Qwen 卖的是"可控"。你拿一个工程工具去跟一个创意工具比审美,输了不冤。
被你忽略的三个开关
但话说回来,Qwen 2.1 的下限确实不该那么低。评论区给出的答案很一致:多数人是在错误的默认配置下跑这台模型。
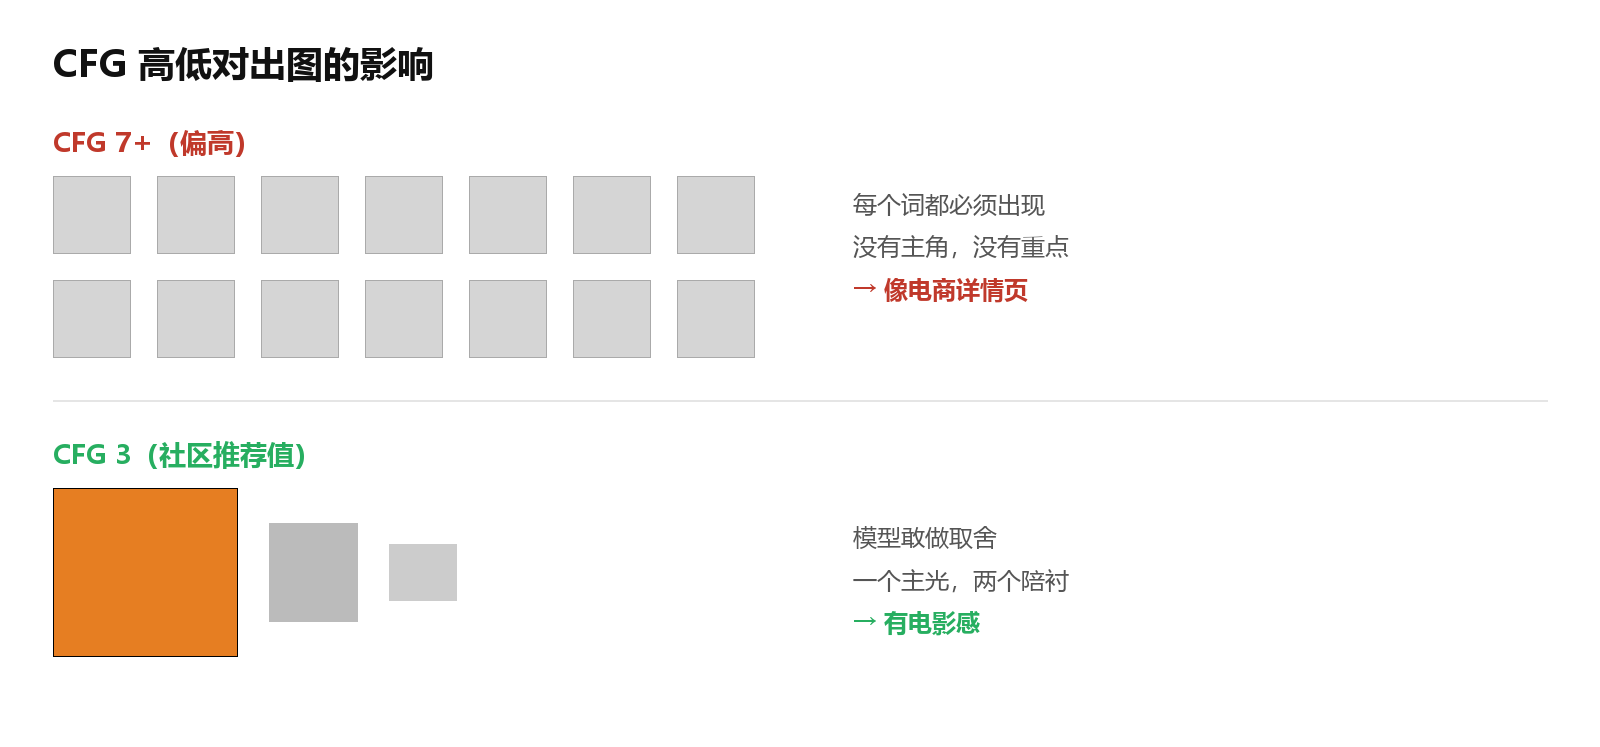
第一个开关:CFG。很多人是从 SD 1.5 年代一路沿用下来的高 CFG 习惯——CFG 越高,模型越不敢偏离你写的每个字,结果就是一张"prompt 覆盖率 100% 但没有任何重点"的图。对 Qwen 这种大指令模型,这个思路是毒药。社区给的做法很干脆:CFG 直接压到 3,你会觉得换了个模型。想再精细点,直接切到 _cfg_pp sampler,正负提示词的对比度是单独控的,比硬压 CFG 好用。
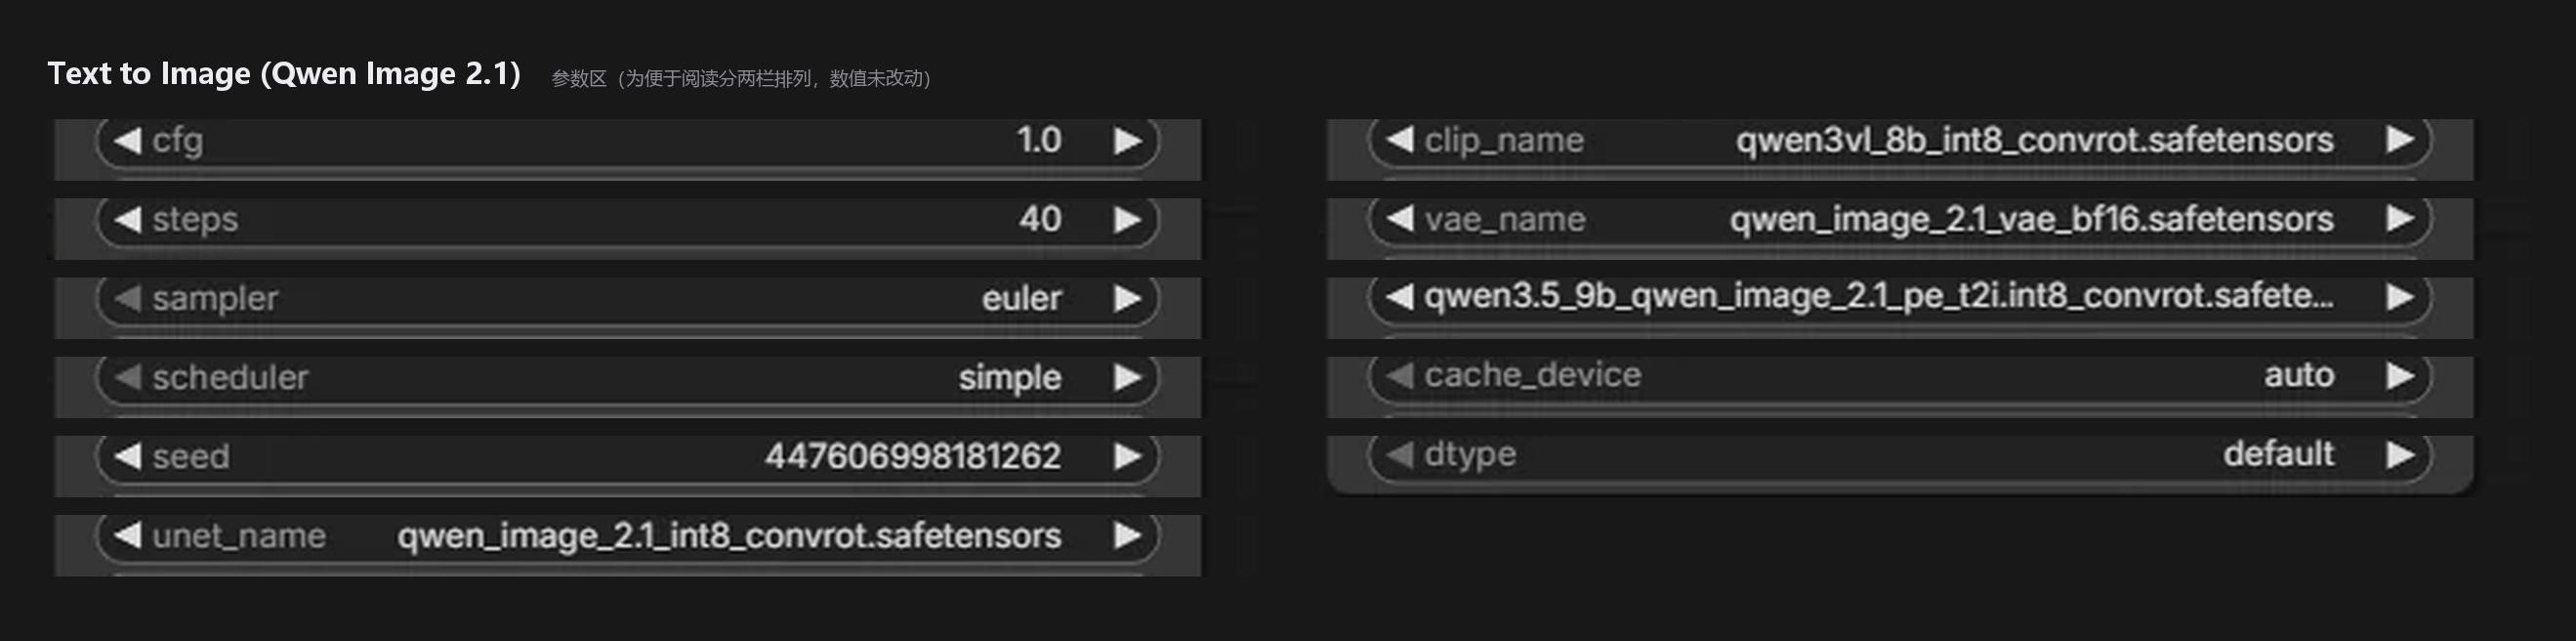
cfg 填的是 1.0;refine_prompt 是 false——这就是下面要说的第二个开关,默认状态是关的;最下面一行挂着 qwen_image_2.1_pe_t2i,pe 即 prompt enhancer。原截图为竖长单列,此处按行拆成两栏以便阅读,数值未改动。第二个开关:prompt enhancer。这是最坑的一个。Qwen 2.1 出厂自带一个配套的 prompt 改写模型,ComfyUI 官方模板里线都接好了,但开关藏在一个节点后面,默认关着。打开之后,你那三行干瘪 prompt 会先被它自己扩写成一段带镜头、带材质、带光影的描述,再喂给图像模型。它甚至会自己判断该出什么画幅。
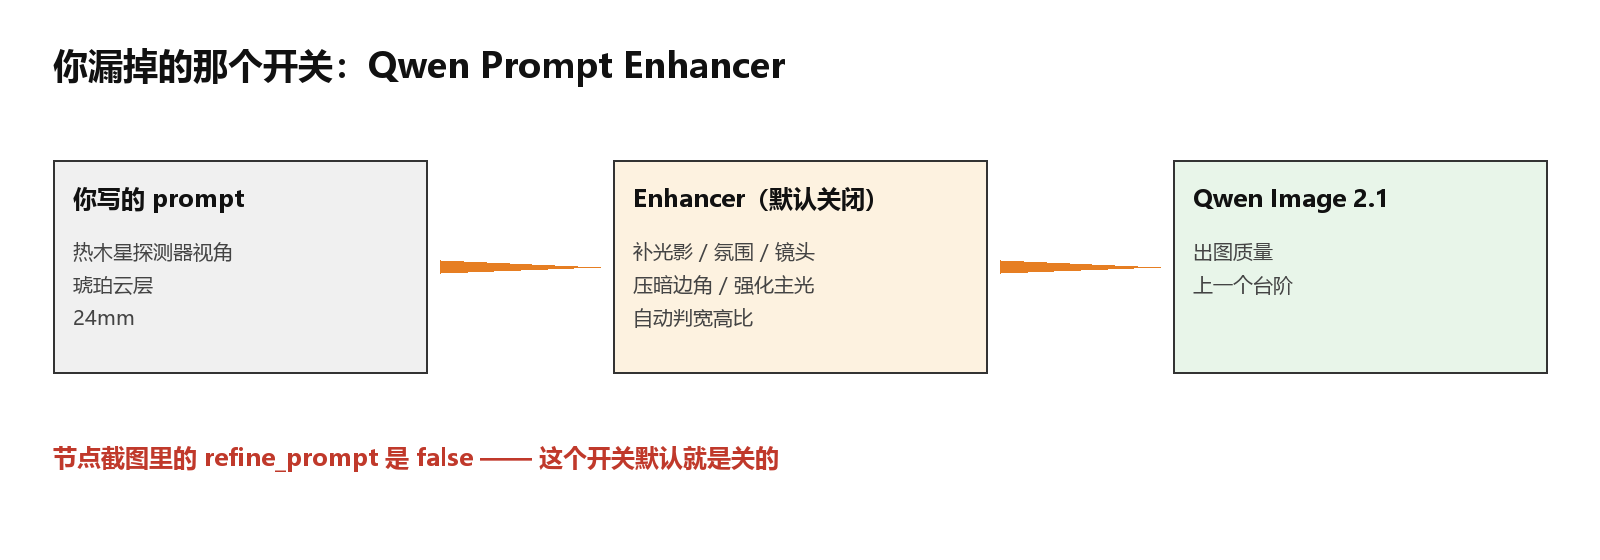
底下有条评论一针见血:"Qwen 对 prompt 相当忠实——所以只要你让 AI 替你写一段足够细的 prompt,它就能把那画面造出来。"(原文:I find that Qwen is quite adherent to prompting, so if you have an AI write you a detailed prompt of what you want, it will create that.)
第三个开关:别再硬撑了。评论区最高赞那句话很难听但是真话——"flogging a dead horse with 2.1, it's the worst model to drop for at least two years"(用 2.1 是给死马抽鞭子,它是至少两年来最差的一次发布)。如果你要的就是 Midjourney 那种饱和度、那种电影感、那种你说不清但就是觉得"酷"的东西,社区现在的标准答案不是调参,是Krea 2 底模 + 一个 Civitai 上成熟的 MJ style LoRA。权重拉到 0.6~0.8,不需要训练,plug and play。
评论区里被反复贴出来的几个:midjourney-style(v6 语义)、midjourney-7-vibes、krea2midjourney 专用融合版。有人实测过——Krea 2 Turbo 在 4070 8G 显存上出 2560×1600,175 秒。
模型不该按"谁强谁弱"排座次,该按"谁干什么活"
做游戏这十几年,我见过太多团队在工具选型上犯同一种病:买最贵的、跑最大的、追最新的,然后拿 Photoshop 干 Excel 的活。
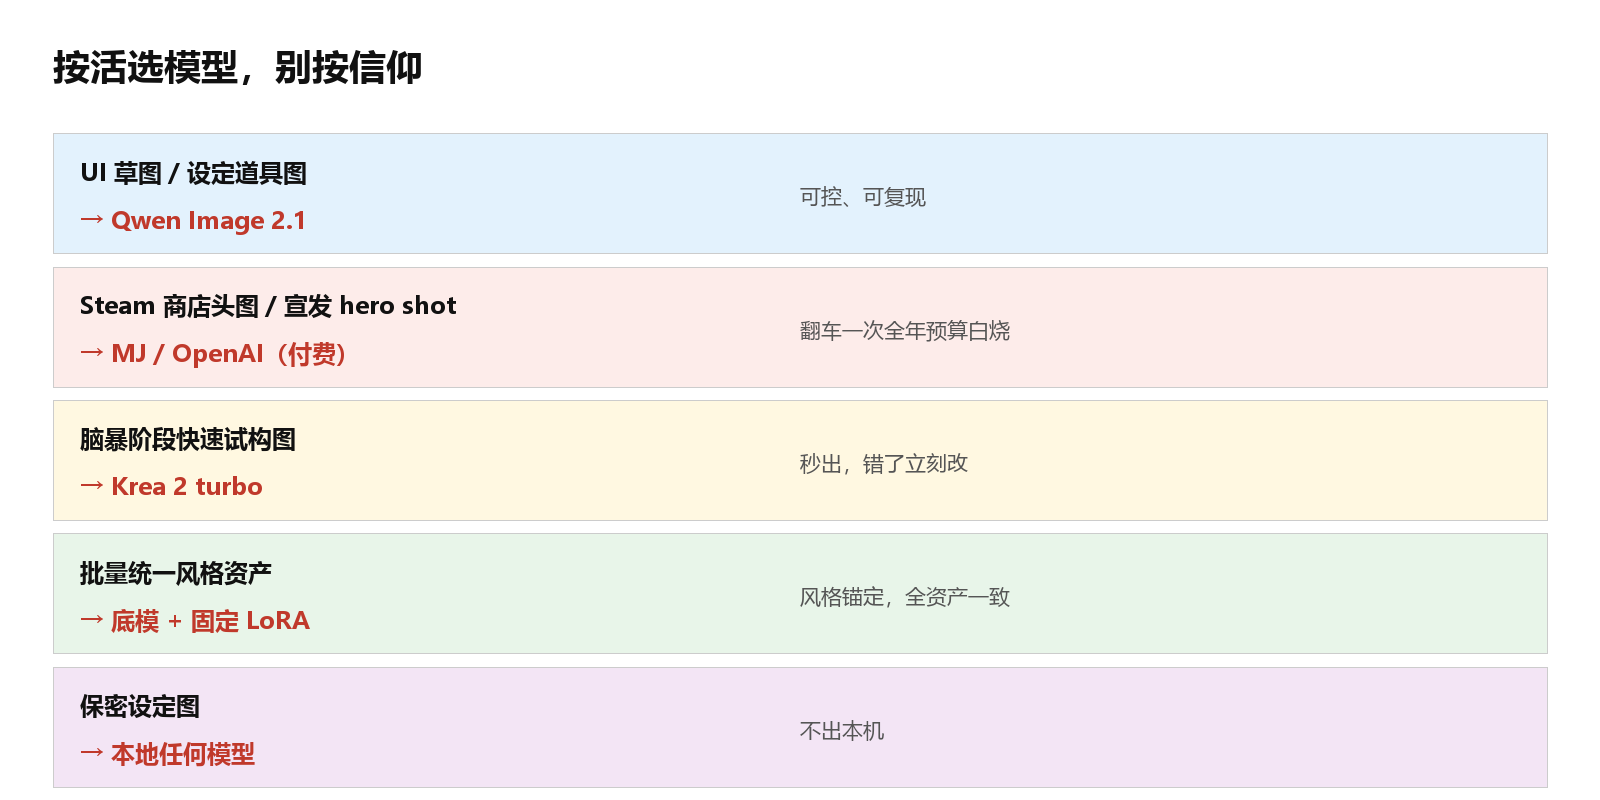
| 你要干的活 | 该用谁 | 为什么 |
|---|---|---|
| UI 草图、场景布局、道具图——必须严格对设定 | Qwen Image 2.1 | 听话,可复现,同一个 prompt 跑十次误差小 |
| Steam 商店头图、给发行商的 hero shot、宣发海报 | 付费 MJ 或 OpenAI | 这个位置翻车一次,全年预算白烧 |
| 脑暴阶段快速试构图 | Krea 2 turbo(4~20 步) | 秒出,错了立刻改,不心疼显卡 |
| 批量出风格统一的资产 | 底模 + 固定 LoRA 锚点 | 比反复调 prompt 稳十倍 |
| 保密设定图、不能出本机的内容 | 本地任何模型 | 没得选 |
你看到差距最大的那张对比图,往往不是模型之间的差距,是你拿 Qwen 的工位去打 MJ 的仗。
真正该盯的,不是模型榜,是"风格资产化"
这两个月 ComfyUI 生态里有个变化,比"谁跑分第一"重要得多:风格正在变成一个可以打包、可以复用、可以跨模型带走的东西。
MiniMax H3 让你扔一段参考视频进去,说一句"照这个动画风格、这个镜头节奏出",它就照做。Krea 2 把一套视觉语言压成一个几十 MB 的 LoRA。最近那个 OmniChar 更狠——把角色的脸、衣服、声音封装成一个 .char 文件,你今天用 Flux 出,明天换 SD3.5,角色还是同一个人。
这件事对独立团队的意义,比"Qwen 2.1 是不是不如 MJ"大一个数量级。
过去你要统一一个游戏的画风,得养一个主美带三四个执行美,画半年才能把整套视觉语言磨出来。现在你找到一段你要的参考——可能是某个片子的截图、某个艺术家的作品集——压成 LoRA,之后所有概念图、迭代图、宣发图都从同一个锚点长出来。
大厂养美术组,你养 LoRA。这不是玩笑,是 2026 年独立开发者第一次拿到了和大厂在视觉产能上对标的工具。
最后一句不太政治正确的话
本地跑模型从来不是信仰问题。它就是两件事:便宜,和不出本机。
所以下一次,当你想为了省几美元 API 费用,在本地折腾一晚上调一张要给投资人看的图的时候——停手。直接付费出。那张图的质量差一档,丢掉的可能是几百万的投资。
本地管线该干的活,是便宜地批量出草样、是快速试错、是攒你自己的训练数据、是画那些不能让任何第三方服务器看见的保密设定。
模型没欠你什么。你只是给它派错了活。
本文基于 Reddit r/StableDiffusion 公开讨论整理:Qwen Image 2.1 vs OpenAI。对比图来自原帖,观点仅代表作者个人。