2026-10-08 第二次修订:① 全量不砍减(Halo 与公众号/知乎文章同为无上限长文承载位);② 彻底通俗化重构(术语换白话、先场景后展开、抽象配类比;数据/表/图/来源一个不删)。 本文件由
tools/rebuild_halo_master.py从知乎版.md回灌生成;发布稿由tools/make_publish_md.py生成。
做游戏的人都碰过这道选择题:游戏里的 AI NPC(那些会说话、会做事的角色)该说什么、该做什么,是提前写死,还是每次都去问 AI?
写死的省事——可控、便宜、不卡顿。但玩家问三句话就露馅了:这不就是个会念台词的木桩吗。
每次都问 AI 呢?聪明是真聪明,可它又贵又慢又不听话:同一个 AI NPC,上午跟你有礼貌,下午突然变了个性子。出了 bug 更麻烦——你都不知道该去哪改。总不能去改模型的"脑子"吧?
最近 AI 圈在聊的事,其实就是这道题的产业版。而且这次,答案有一半已经不是纸上谈兵了:真有人做出来了,还甩出了 1242 个任务的实测数据。
先说清楚:这道题为什么值得往下看
刚才那两条路——写死的 AI NPC 太呆,全靠大模型现想的 AI NPC 又太贵——行业卡在中间卡了十几年。要么呆,要么贵。
而最近冒出来的这批新做法,刚好是从这道题里长出来的。下面这份拆解分两半:
- 上半场是别人已经跑出来的东西,有真金白银的数据;
- 下半场是我对下一步走向的判断,还只是设想,没有成品。
先看有数据的这半。
上半场:行业已经拆出来的那半步
一个小模型给大模型当"门卫",整体快了一半
有个开源项目叫 Jeff-Code(它是在另一个开源项目"Pi"的基础上改的)。它做的事特别直白:
大模型(27B,算是"脑子大"的那种)每干一件事之前和之后,都先让一个特别小的模型(0.8B)过一遍。这个小模型就像门口的门卫,每次只做一个判断、只要 0.2 秒左右,只问自己两个问题:
第一个问题:这步活我能自己干吗?
读文件、列目录、搜代码、跑测试、跑构建——这些都是体力活。小模型觉得有把握(把握超过 0.40 的概率)就自己干了,最多连着干 8 步,把活儿先铺好。等大模型开工时,答案已经摆在桌上了。
但有一条铁律:改文件、写代码这种"动刀"的活,永远留给大模型。小模型一旦没把握,立刻把活交回去。
第二个问题:这轮大模型需要好好想吗?
大模型不是每步都需要"深度思考"的。只有当小模型判断"这轮够复杂、值得开完整思考"的概率超过 60%,思考才会打开。实测里大约四分之三的轮次,思考都是关着的——省下来的这点"思考力气",就是提速的大头。
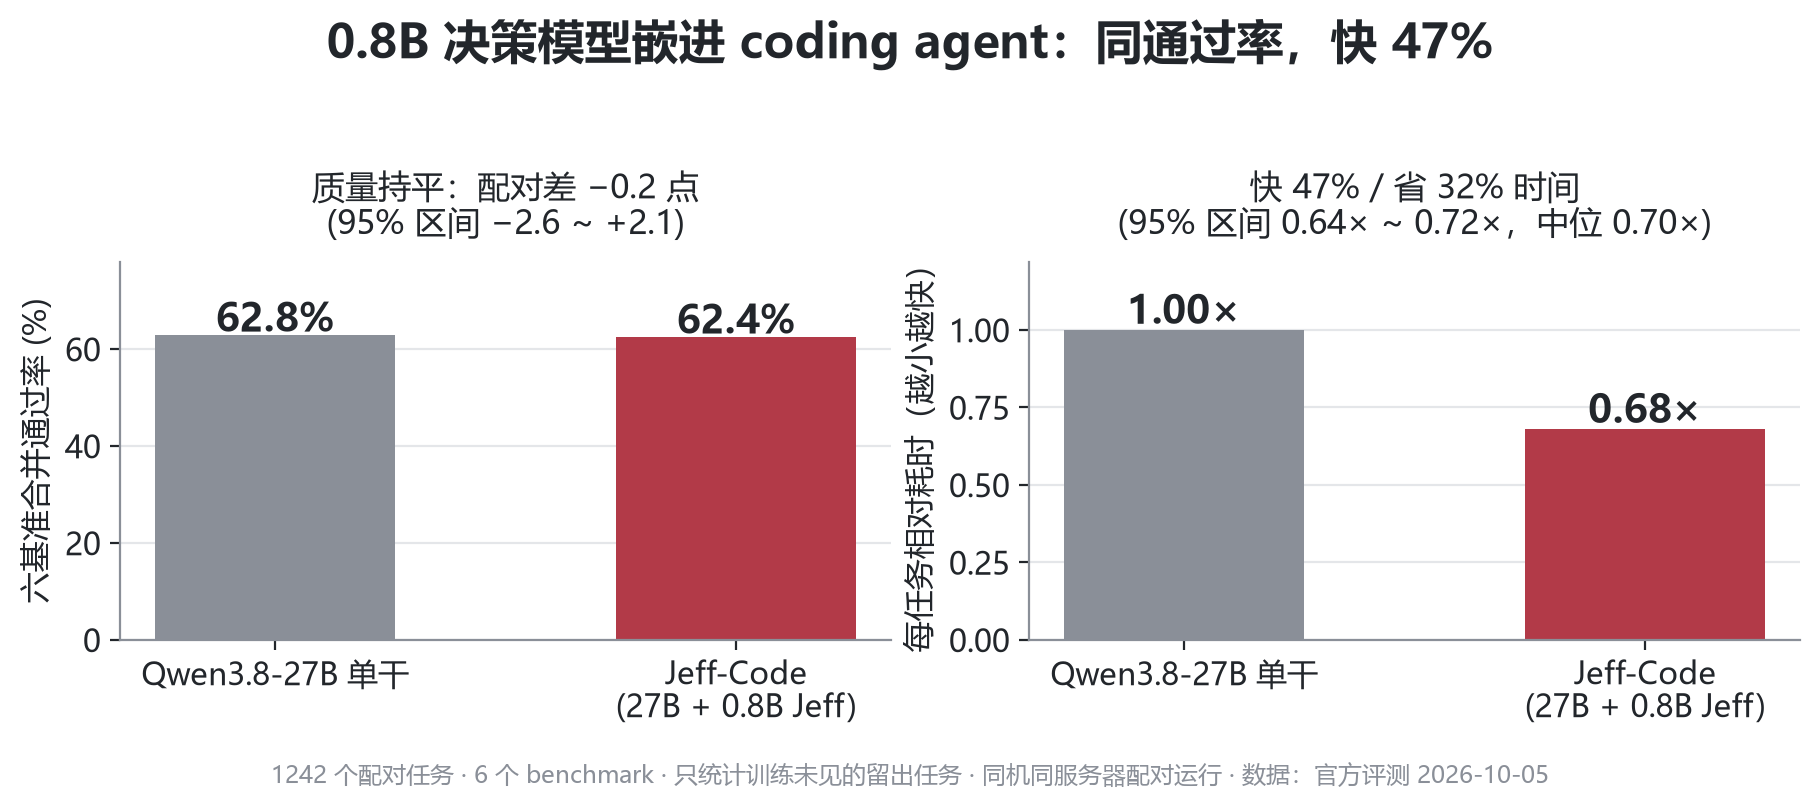
他们跑了 1242 组对照任务(每组两种配置同时、同一台机器并排跑,而且用的都是小模型训练时没见过的题),横跨六个基准。结果是这样:
| 指标 | 大模型单干 | 加 0.8B 门卫 |
|---|---|---|
| 通过率 | 62.8% | 62.4%(基本持平) |
| 每组任务耗时 | 1.00× | 0.68×(快了 47%,省 32% 时间) |
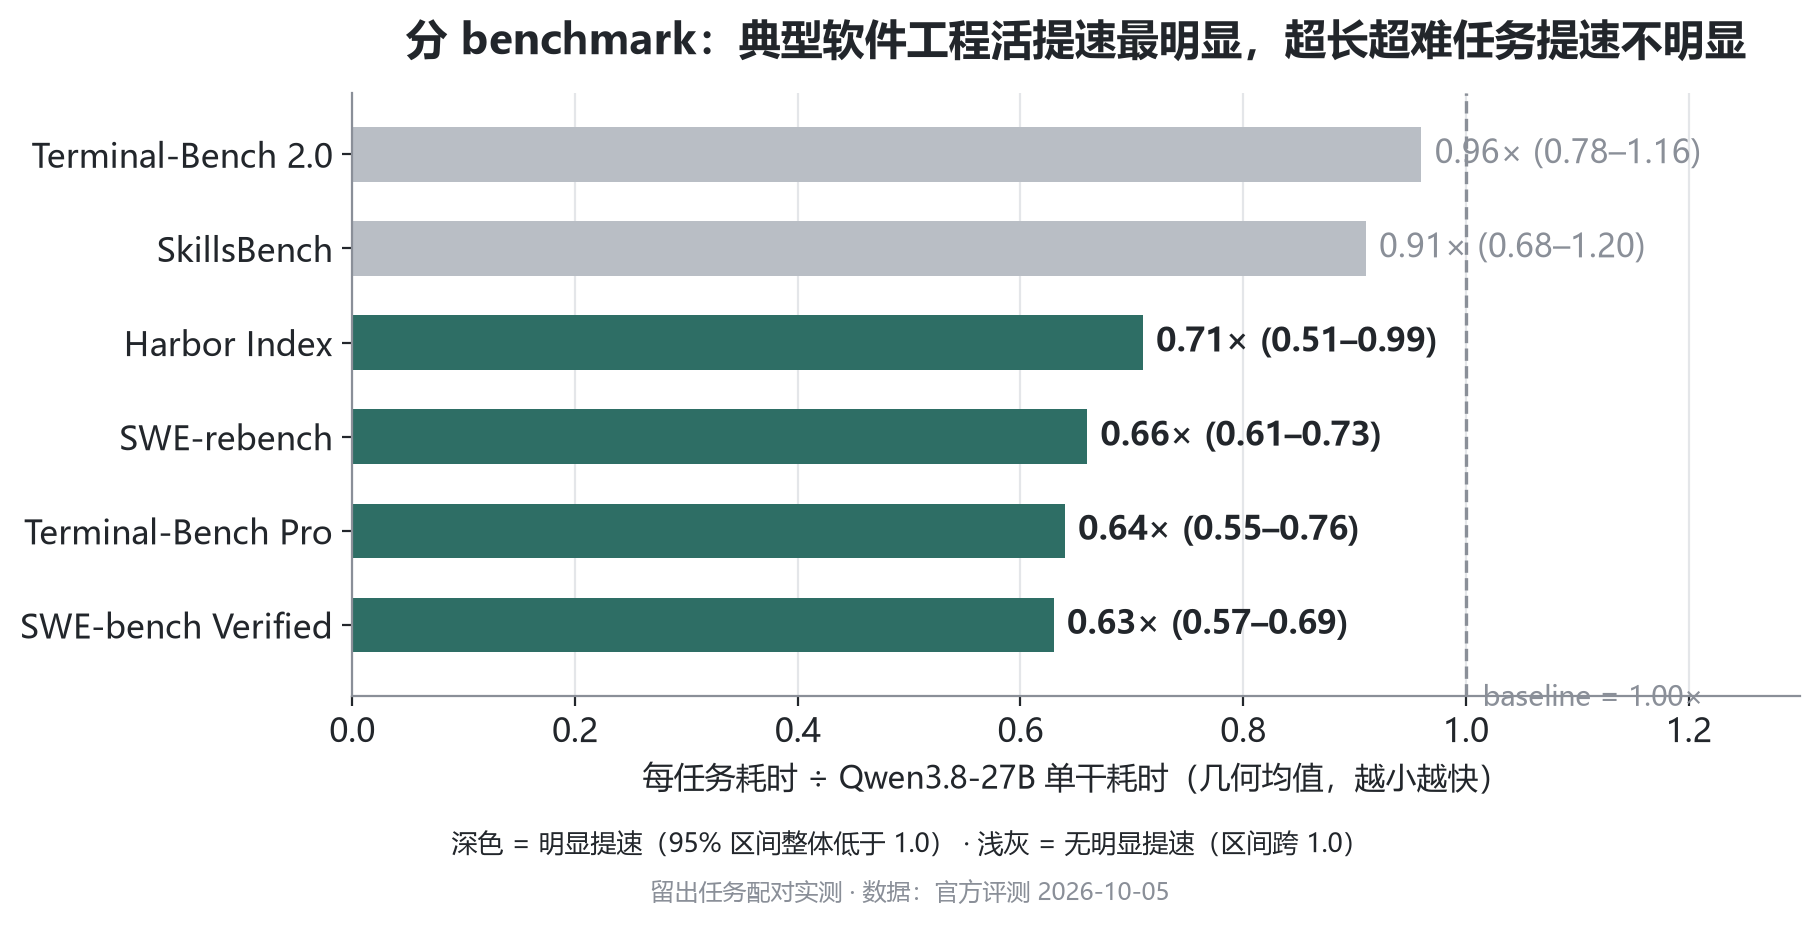
拆开看,规律很清楚:典型的软件工程活提速最猛(SWE-bench Verified 0.63×、Terminal-Bench Pro 0.64×、SWE-rebench 0.66×);又长又难的任务基本没提速(Terminal-Bench 2.0 只有 0.96×)。所有通过率的差异,统计上都在"没差别"的范围里——官方的说法就是"没看出质量变化"。
最有说服力的是那个"反面教材":如果不要这个门卫,直接全程关掉大模型的思考——确实更快,但通过率一下掉 7.6 个百分点,最难的任务上甚至掉 13.5 个百分点。
所以门卫的价值不是"踩着大模型提速",而是它知道哪些思考能省、哪些不能省。
更狠的一点:在"判断类"任务上,小模型反而赢了大模型
别以为这个小模型只能给写代码的打下手。同一批放出来的 15 个适配器里,有一组"做判断"的任务,大小模型同题比了一场:
| 任务 | 27B 单干 | 0.8B + 适配器 |
|---|---|---|
| 挡住提示注入 / 越狱 | 84.0%(3.9 秒) | 98.7%(0.07 秒) |
| 认出垃圾信息和钓鱼 | 88.0%(2.7 秒) | 98.7%(0.08 秒) |
| 决定该调哪个工具 | 90.3%(11.3 秒) | 98.3%(0.32 秒) |
| 8 项平均 | 86.6%(8.1 秒) | 94.6%(0.25 秒) |
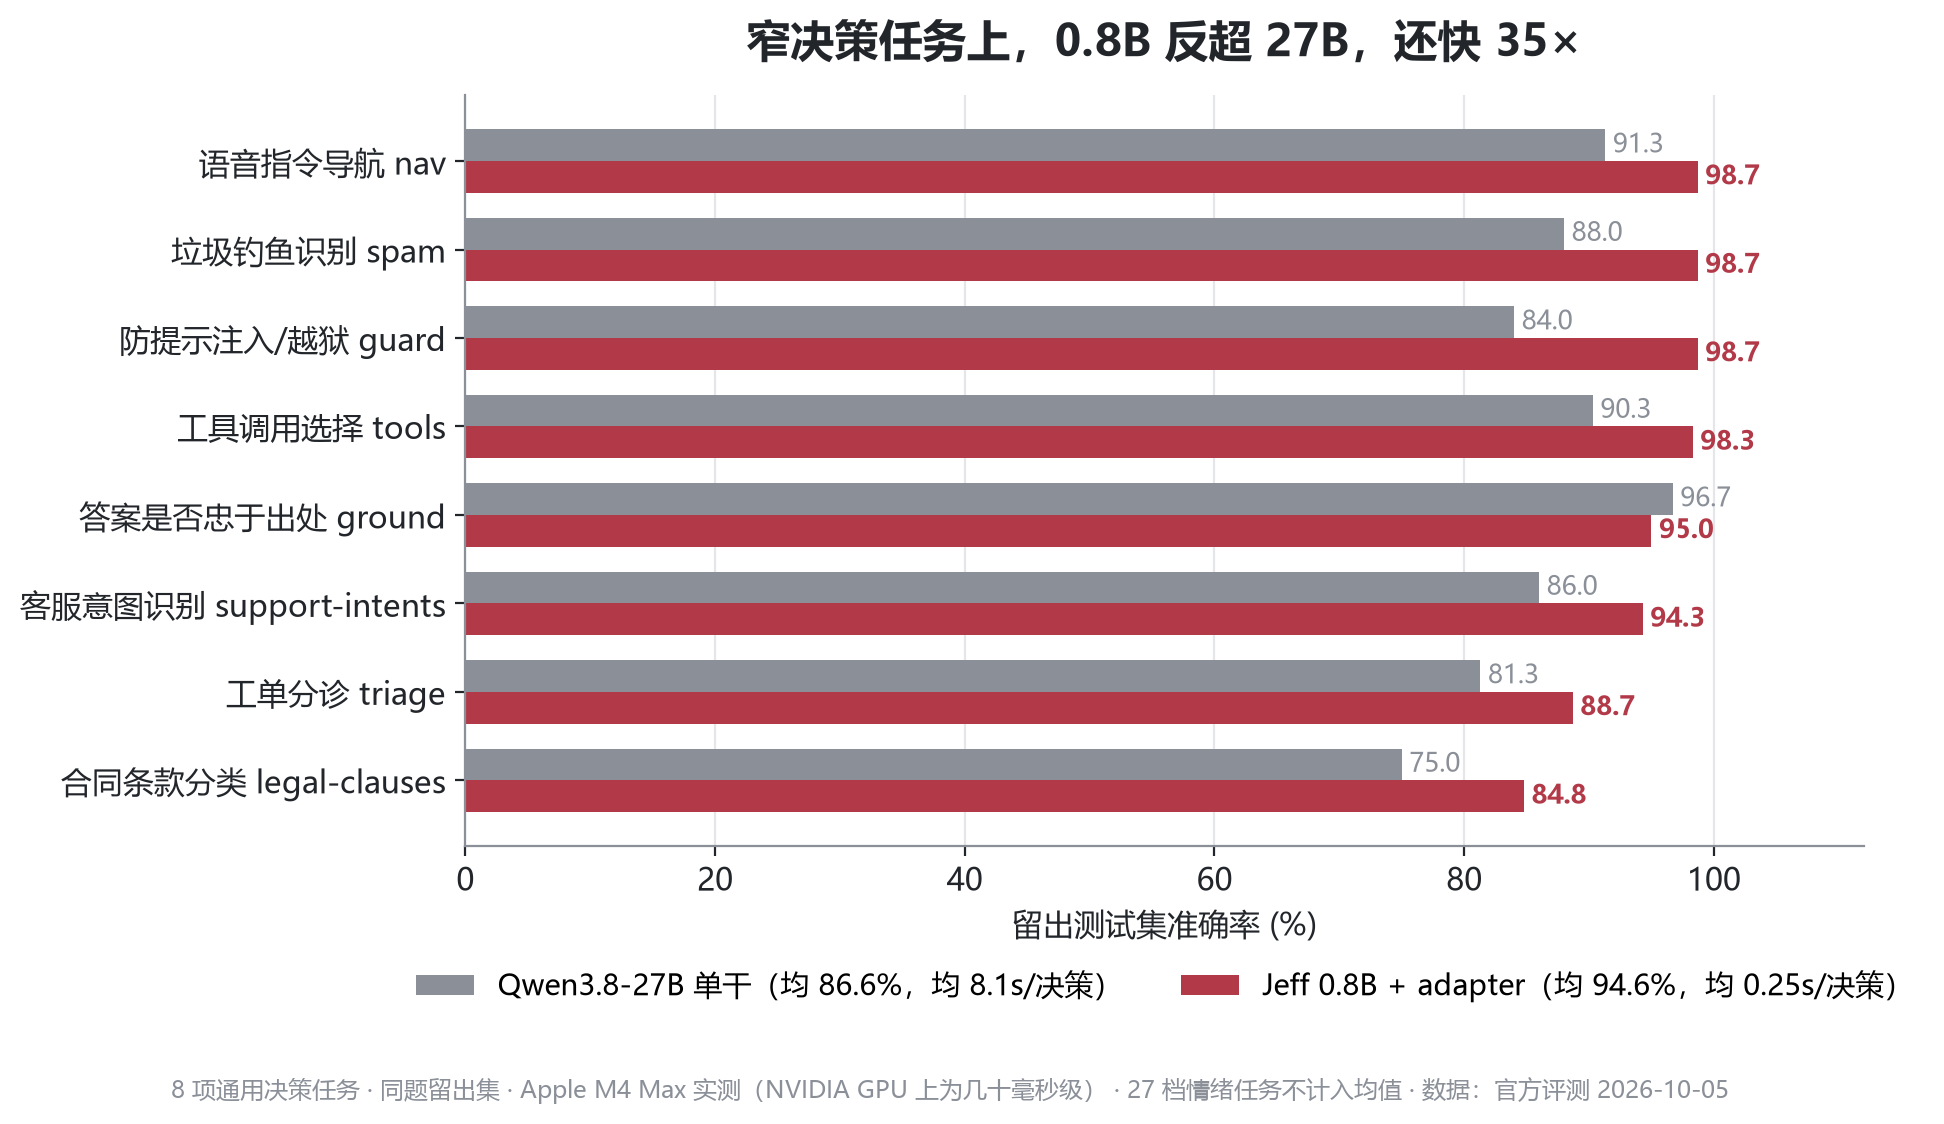
8 项里,小模型有 7 项单独就赢了大模型,平均快 35 倍。唯一输的那项是"判断一段答案有没有忠于原文"——这已经不是简单的判断题了,是理解题。
一句话:该"判断"的活交给小模型,该"理解"的活留给大模型,这条边界清楚得很。
省钱也是一笔:大模型本体要 28.6GB 内存,小模型加上全部 15 个适配器才 2.1GB。
所以,行业到底拆出了什么
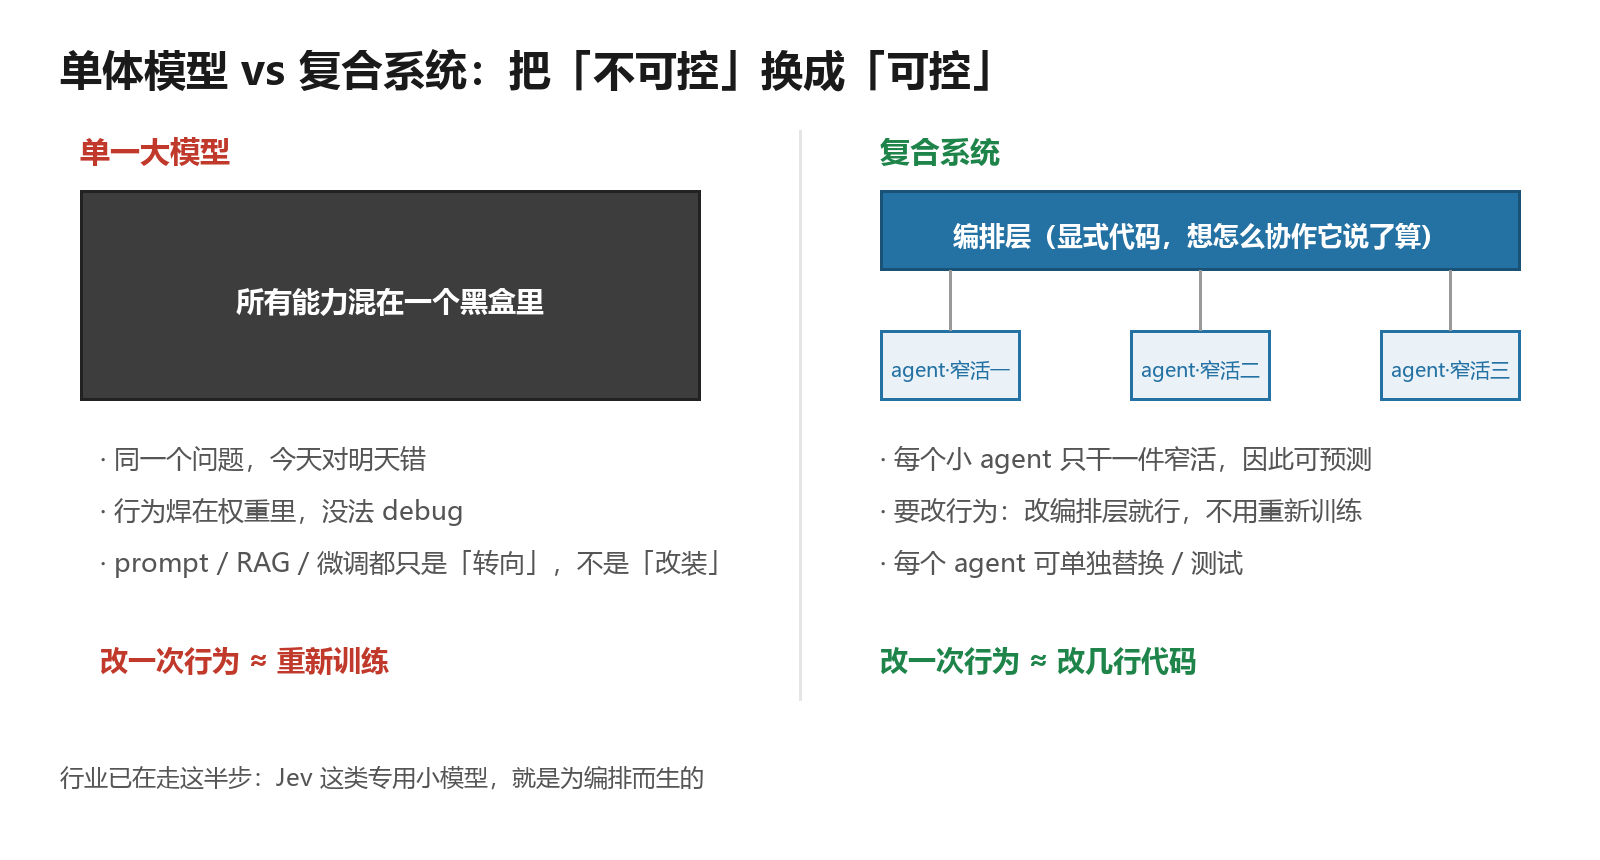
把这个项目,和以前归档过的那批小模型放一起看,信号很清楚:行业正在离开"一个模型包打天下",转向"一队模型分工干活"。
不少来源都在给这个判断撑腰。比如 pipelang.com 在聊"Jev 之后会怎样"时说得就很白:与其指望一个又难预测、又难定制的巨型模型,不如把它拆成好几个又小又专、所以更好预测的小 agent,上面再盖一层人写清楚的"调度层"来协调它们。想改行为?改那层调度就行,不用重新训练。文章还点了名:TypeSafe 家的 Jev,就是这个转向的证据。
游戏圈其实早有类似的证据。以前归档过一个叫 Midira 的项目:400 个 AI 角色生活在《魔兽世界》怀旧服里——用 4B 的小模型负责日常行为决策,27B 只管生成对话。
三个毫不相干的项目(Jeff-Code、Jev、Midira),最后都收敛到了同一个结构:小模型管"动作",大模型管"说话"。
下半场:这套"分工"还差一口气
"一队模型分工"解决了"一个大模型不可控"的毛病。但有个地方没弄干净:这套队伍,还是人搭的。
谁负责干什么、调度层怎么写,全靠工程师一行一行敲出来。模型只负责在系统里当员工,不负责设计这个系统。
再往前一步,就是接下来要讲的东西。这里必须先划一条线:下面这部分是设想,还没有公开的东西做出来——不是上半场那种有实测数据的工程成果,而是行业观察者对未来形态的猜想。请带着这个前提往下看。
让模型"连系统一起交出来"
设想中的下一步,被叫做 reasoning by construction(构建式推理)。它的核心动作很反直觉:
模型收到问题后,不直接给答案,而是先搭出一个"小团队"——一堆各干一件窄活的小 agent,再加一段调度的代码;然后把这个团队跑起来;最后交给你两样东西:答案,和这个团队本身。
这个被交出来的"团队",有个名字叫 reasonlet。
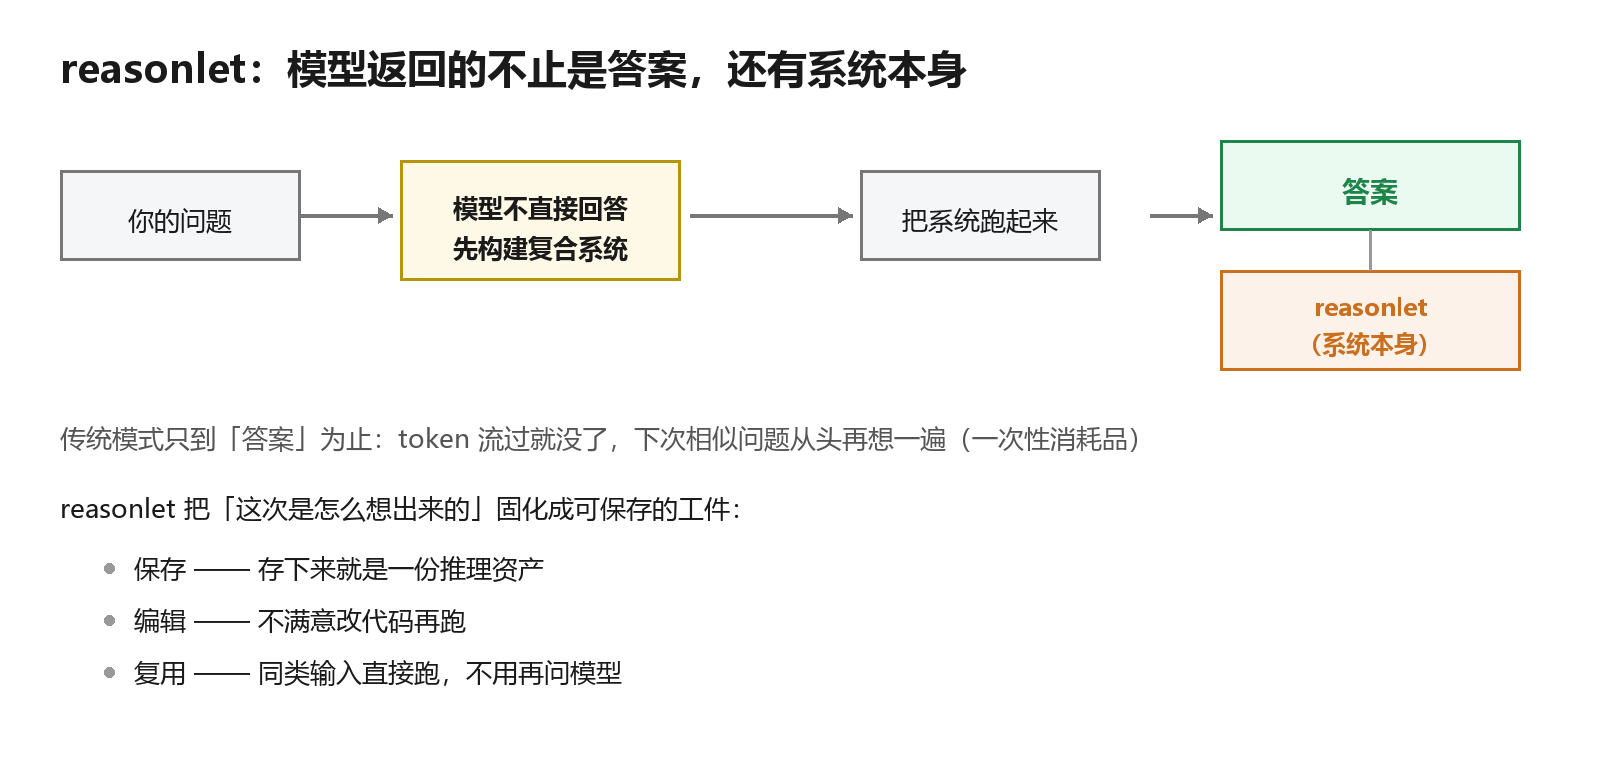
第一次看会觉得多此一举:我要的是答案,你给我一堆代码干嘛?
妙处全在这段代码上。传统模式下,模型"怎么想出来的"这个过程是一次性消耗品——算完就没了,下次碰到相似的问题,得从头再想一遍。而 reasonlet 的思路,是把"这次是怎么想出来的"变成一个能存下来的东西。
把"怎么想的"变成能存、能改的资产
有了 reasonlet,能缓存的东西就从"数据"变成了"推理过程本身"——这被叫做 metacache(元缓存):
- 存在本地:reasonlet 就存在你本地。下次碰到同类新输入,直接跑这段代码,根本不用再问模型——不花 token、没有延迟、结果还稳定。
- 能改:不满意它的思路?直接改代码再跑。这在单体大模型上想都不敢想——模型的行为是焊在"脑子"里的,prompt、RAG、微调说到底都只是"哄它转向",不是"拆开改装"。
- 厂商那边也能复用:模型供应商也能缓存 reasonlet——不同用户提了相似的请求,直接复用一个现成的"团队",省下的是全行业的算力。
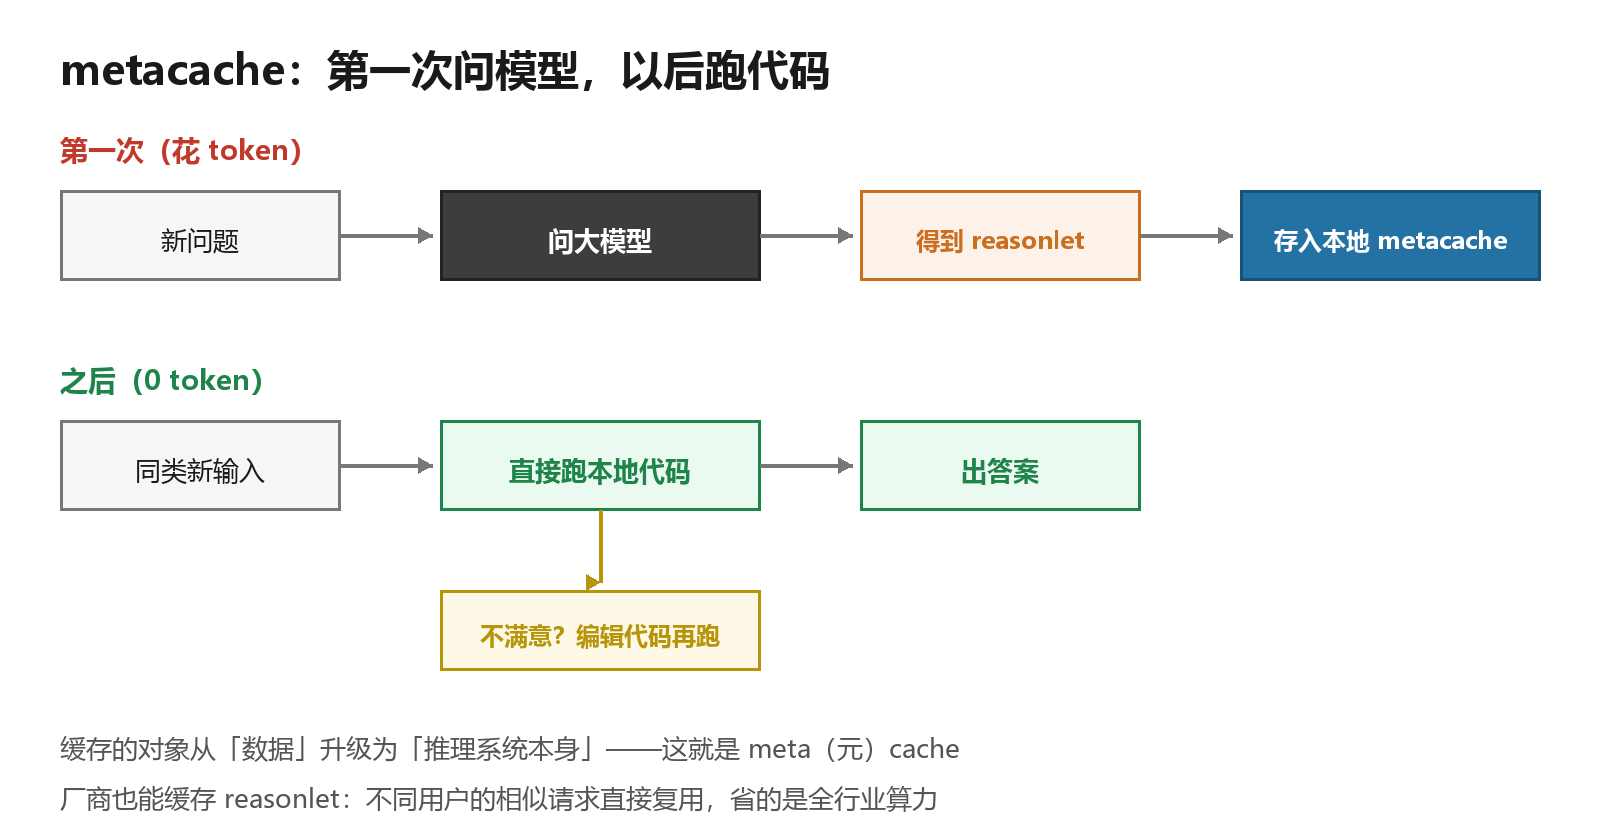
把"单体大模型"和"代码"摆一张表里看,取长补短的道理就清楚了:
| 单体大模型 | 代码 | |
|---|---|---|
| 好不好预测 | 差——同一个问题今天对明天错 | 强——写什么就跑什么 |
| 好不好改 | 差——行为焊在权重里 | 强——改代码就行 |
| 怎么来的 | 训练时自己"长"出来的 | 传统上必须人一行行写 |
单体大模型的长处是能自己长出本事,短处是不可控;代码的长处是可控可改,短处是得人来写。reasonlet 想干的,就是把两者的长处接上:让模型去写代码,人保留改代码的权利。
两半拼起来,才是完整的
到这儿可以把上下半场拼上了:
- 上半场(已经落地)证明了一件事——把大模型拆成"小模型做判断 + 大模型做推理",质量不掉、速度快 47%。"分工"的价值,有硬数据托底了。
- 下半场(还只是设想)指出了下一步——把搭好的这套系统本身,变成一个能存、能改、能反复用的资产,让"推理"从消耗品变成资产。
上半场是"拆",下半场是"存"。拆,已经有人做到了,还挺快;存,方向已经清楚,就等着落地。
做 AI NPC:这套东西是现成的落地姿势
绕回开头那道题。对做游戏的人来说,上面这一整套一点都不科幻——做 AI NPC,本来就是干这个的:
让大模型针对某个 AI NPC 生成一份行为树 / 状态机的代码,存下来;之后这个 AI NPC 的日常举动,全在本地跑这份代码,不用每次都让大模型现想。
对着刚才讲的三条,每一环都是现成的:
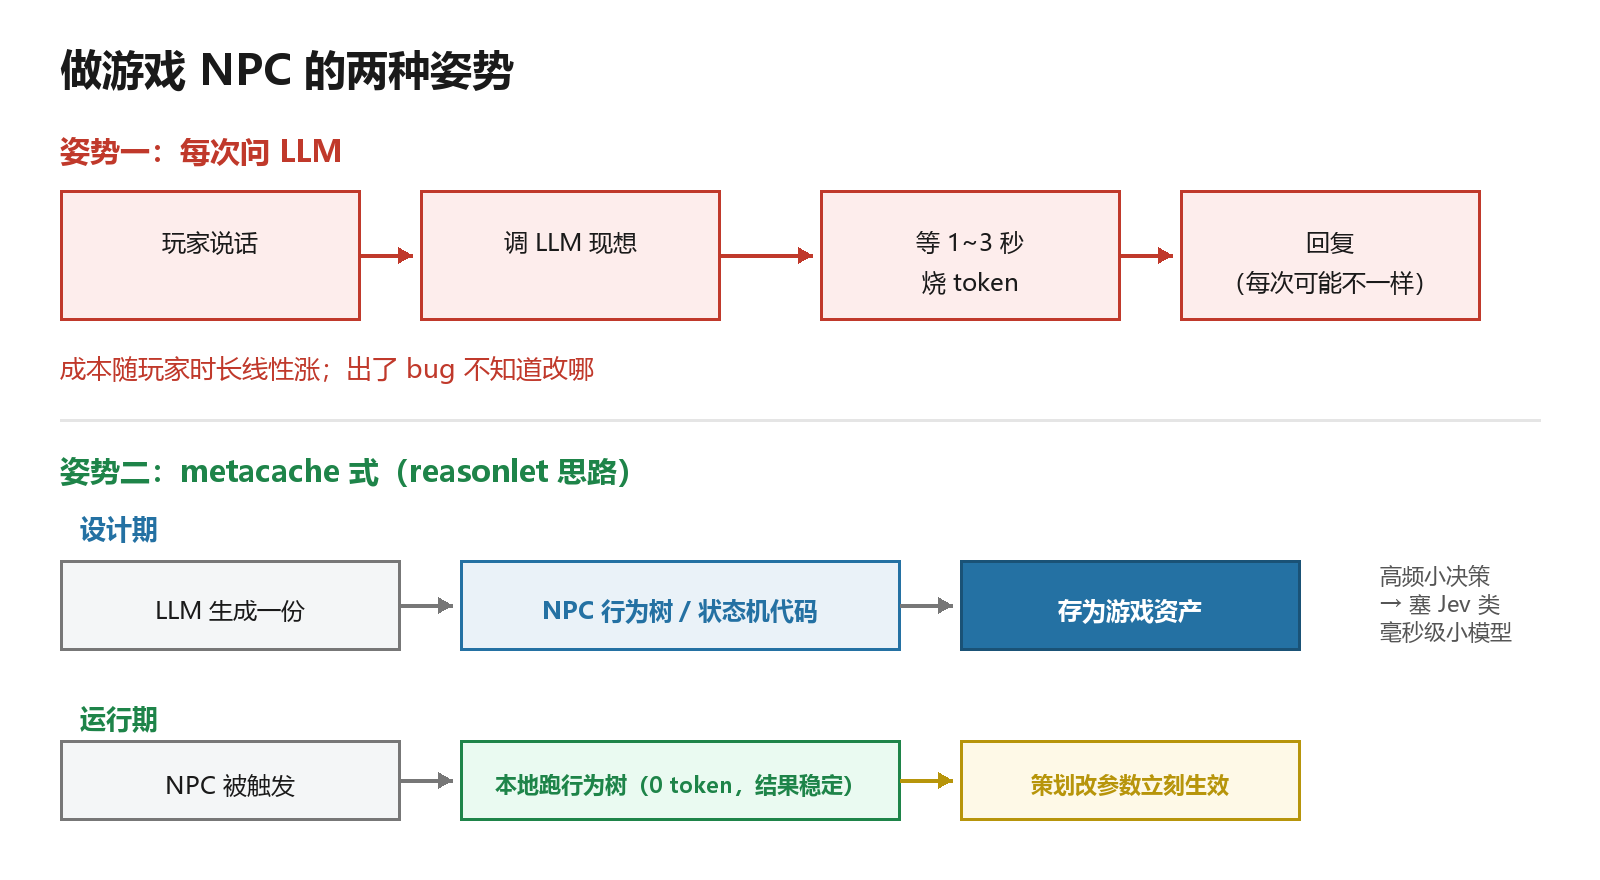
- 存在本地:行为树就是 reasonlet 的游戏版。酒馆老板怎么接待、卫兵怎么巡逻盘查、商人怎么讨价还价——各存一份代码资产,随场景加载。
- 能改:玩家反馈"这老板太啰嗦"?策划直接改行为树的参数就行,不用重跑一遍大模型、祈祷它这次想对。改的就是资产本身,改完立刻生效。 这才叫真·游戏策划工作流。
- 成本整个反过来:老做法里,每个 AI NPC 每说一句话都在烧 token,成本跟着玩家玩多久一路涨;换成本地跑代码,token 就花在设计期,运行期几乎不花钱。玩家越多,反而越划算。
再往下接一层,就搭上了上半场那个已经有实测数据的东西:行为树里那些高频的小决策(该转向哪、该打谁、该不该搭话),正好塞进 Jeff 这种毫秒级的决策小模型。 大模型负责"设计人格"、小模型负责"秒级反应"、行为树负责"搭骨架"——这就是"分工"这套东西在游戏里该有的完整样子。而且其中"小模型做反应"这一环,已经有人拿数据证明可行了。
结尾:推理,正在从消耗品变成资产
reasoning by construction 这几个词值得记一下。它说的不是"模型变强了",而是推理这个东西的形态变了:从一段算完就没了的 token,变成一份能存、能改、能反复用的代码。
对做内容的行业来说,这意味着真正值钱的,不再是一次聪明的回答,而是"你是怎么得出这个答案的那套系统"。对游戏来说,AI NPC 的智能第一次能像美术资源、关卡数据一样,进资产管线——生成一次,打磨无数次。
而且这一次,不是纯设想:拆开做已经证明更快了,剩下的只是怎么把它存下来。
下次做 AI NPC,可以试试让模型先给你交一份行为树,而不是一段对话。
事实与来源分层说明:文中 Jeff-Code 的通过率、耗时、通用任务等数据,均来自该项目官方仓库与数据页(维护者供数 2026-10-05),属已实现的实测结果;reasonlet / metacache / reasoning by construction 属 pipelang.com 及海外开发者社区的构想,尚无公开实现,文中已注明为概念推演。Jeff v1.0 时期数据出自 2026-10-02 归档研究笔记。"游戏 NPC 行为树"应用思路为作者本人观点。观点仅代表作者个人。