我用 AI 攒了一套游戏 App Icon:8 张图,同一个画风,零美术功底
先上两张图,分别来自两个工具,你感受一下是不是同一个画风。
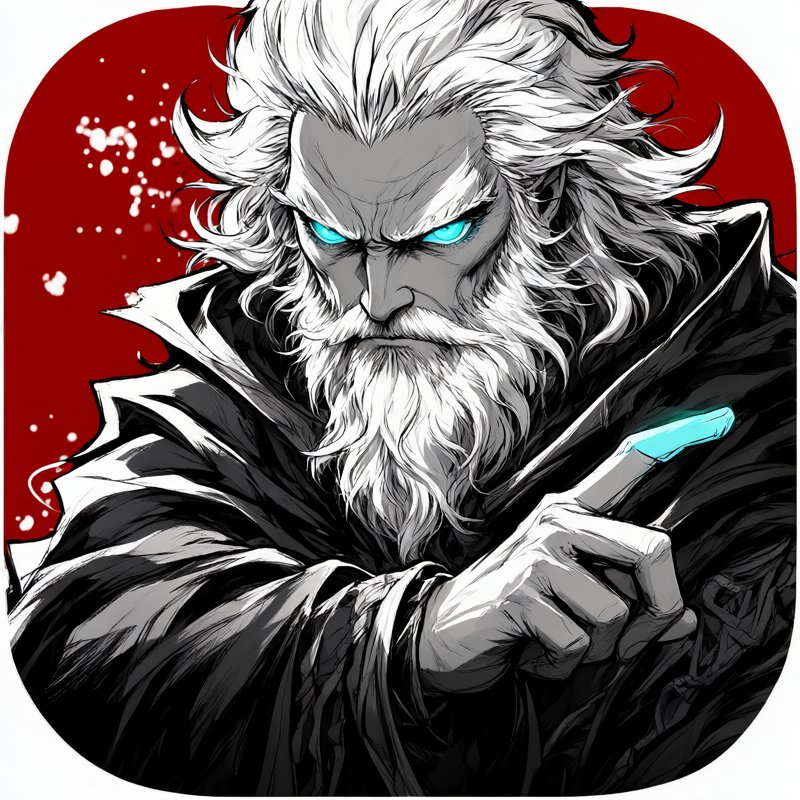
第一张,ComfyUI 本地跑的:
第二张,豆包出的:
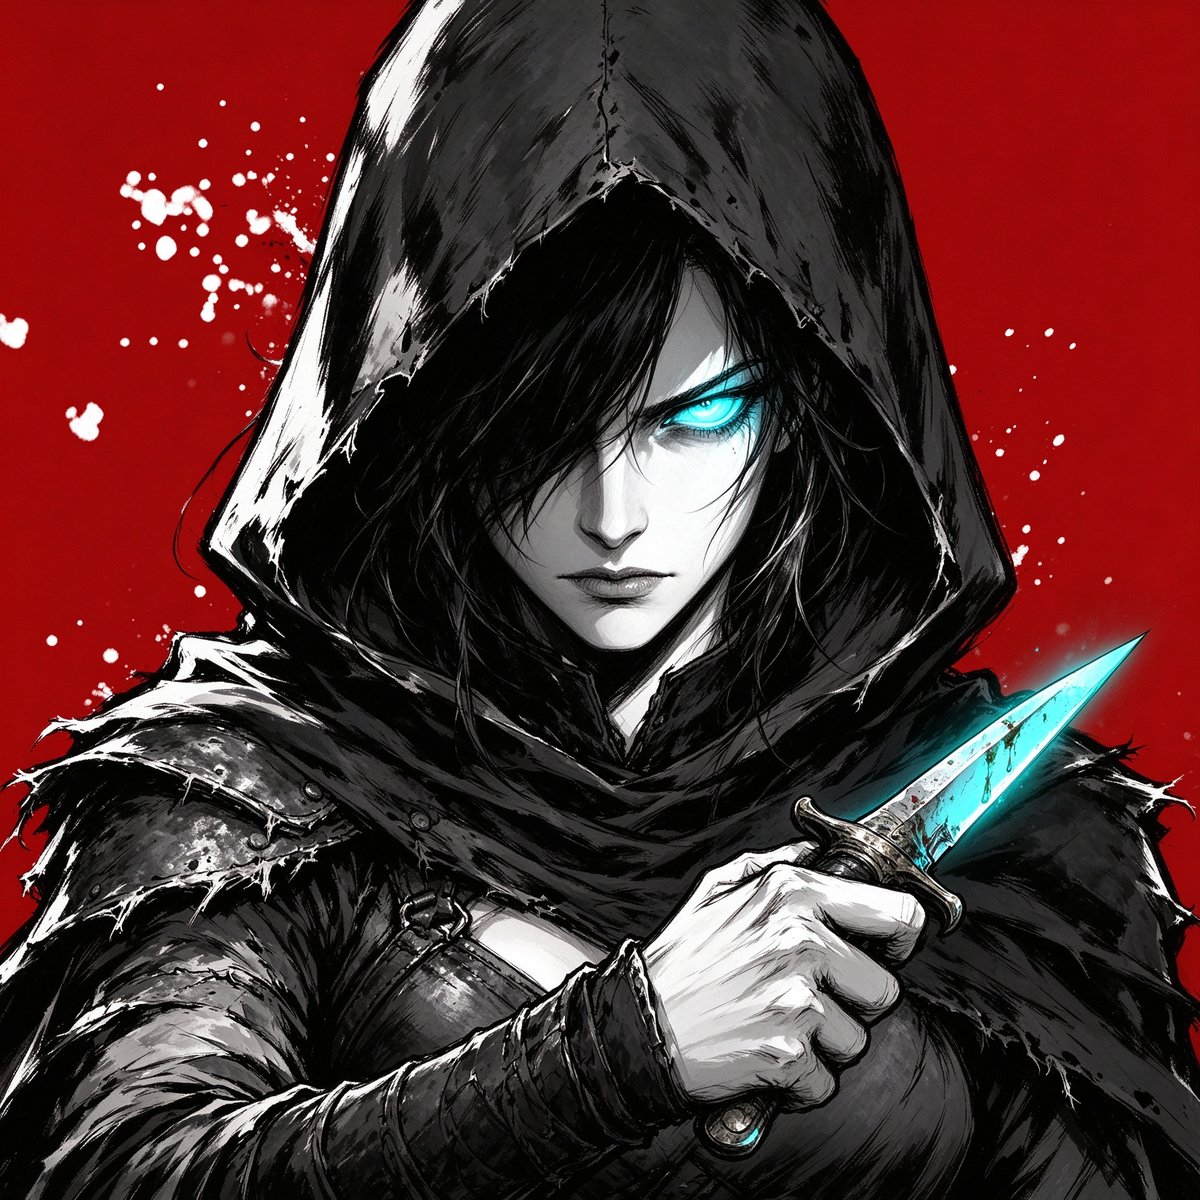
看出来了吗?这是圆角方形——游戏 App Icon 的尺寸。但同时,它也是一张完整的角色肖像。一个图,两个用途:塞进游戏目录是应用图标,裁一下就是 NPC 对话头像。
八张图。八个角色。七张是 ComfyUI 本地跑的,一张是豆包试的——但你一眼就能看出来,这是一套东西。
同一个红底,同一支钢笔,同一种青蓝色的光。像从某本漫画里撕下来的八张角色卡,也像某个即将做的独立游戏里等待上架的图标。
这篇文章讲的就是:怎么用本地 ComfyUI 把一个暗黑漫画画风锁死,再批量产出一整套游戏图标。
工具分工先讲清楚:七张是 ComfyUI 本地跑的,一张是豆包出的。 ComfyUI 是主力生产线,豆包出了一张刺客作为交叉验证——两边各出一张,你看是不是同一个画风。
一、起点:本地 ComfyUI 第一发
最开始其实是个意外。我在本地 ComfyUI 里搭了个工作流,本意只是想试试"墨色暗黑漫画风"到底能出到什么程度。提示词写得很散,大概意思就是:黑白钢笔、木刻版画、朱红背景、只有眼睛发蓝光。
出来的就是第一张老巫师。
盯着那张图看了大概十秒钟,我意识到一件事:这个画风,能打。
不是那种"AI 味很浓但勉强能用"的能打,是那种直接可以当游戏图标用的能打。朱红底压得住场面,钢笔线条够硬,半边脸埋在阴影里有戏,那一点青蓝发光像漆黑房间里唯一的霓虹。
为了看看这个画风延展到现代角色身上是什么效果,我又用豆包出了一张年轻女刺客——兜帽半脸、淬毒短刃、刀刃发蓝光。出来一看,风格居然和 ComfyUI 跑的老巫师是同一个路数。
这一下我心里有底了:这个画风配方,换角色也不崩。
二、画风密码:三色配方是怎么锁死的
很多人用 AI 出图的问题是——什么都想要。要色彩丰富,要细节爆炸,要八头身完美比例,最后出来一堆糖水片。
这套画风之所以成立,核心就一个字:省。
我把这套视觉语言拆成四层,你以后想复刻,照着这四层加提示词就行。
第一层:线必须硬。 钢笔蘸水笔画出来的线条,边缘是刀切的,不是晕染的。有飞白,有顿挫,像木刻版一刀一刀刻出来的。不是日系赛璐璐的光滑平涂,是美漫原稿那种带毛刺的硬边。
第二层:明暗必须狠。 纯黑白灰三色阶,不要中间过渡。人物半边脸直接扔进阴影里,眼睛从黑暗里亮出来。这叫 chiaroscuro——暗黑绘画的老办法,但 AI 出图里用的人不多。大多数人在追求"柔和光影"的时候,反其道而行之效果反而好。
第三层:颜色必须少。 这是最关键的一步。全图只有两个地方有颜色——背景朱红,发光处冷青蓝。其他全是黑白灰。你管这叫"选择性上色"也行,管这叫"主动克制"也行。关键是:不是图只有两个颜色,是你主动规定了只有两个颜色存在。
第四层:要有呼吸感。 背景不能是死的纯色块。撒一点白色墨点飞溅上去,像墨汁甩在宣纸上。不多,就零星几点,画面立刻活了。
四层叠起来,就是这个配方:朱红底 + 黑白墨线 + 一点青蓝 + 几点白墨。
这个配方有多好用?你拿去套任何角色都成立——巫师、刺客、白领、黑客、法师、侦探。题材随便换,画风不散。
三、从一张到一套:ComfyUI 批量出图
刺客那张出来之后,我确认了一件事:这个画风配方成立。那接下来就简单了——回到本地 ComfyUI,换提示词批量出角色。
下一张我想试试现代题材——一个戴眼镜的职场女性,穿西装,手里拿个发光的手机。
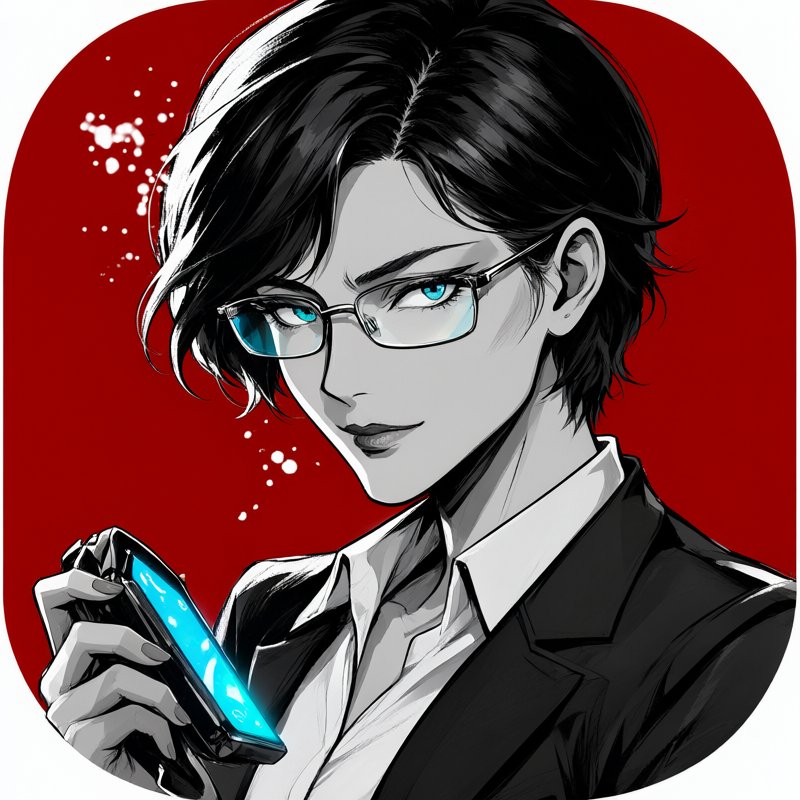
出来之后我愣了一下:红底、钢笔线、眼镜片反射青蓝色——居然跟奇幻角色放一起毫不违和。
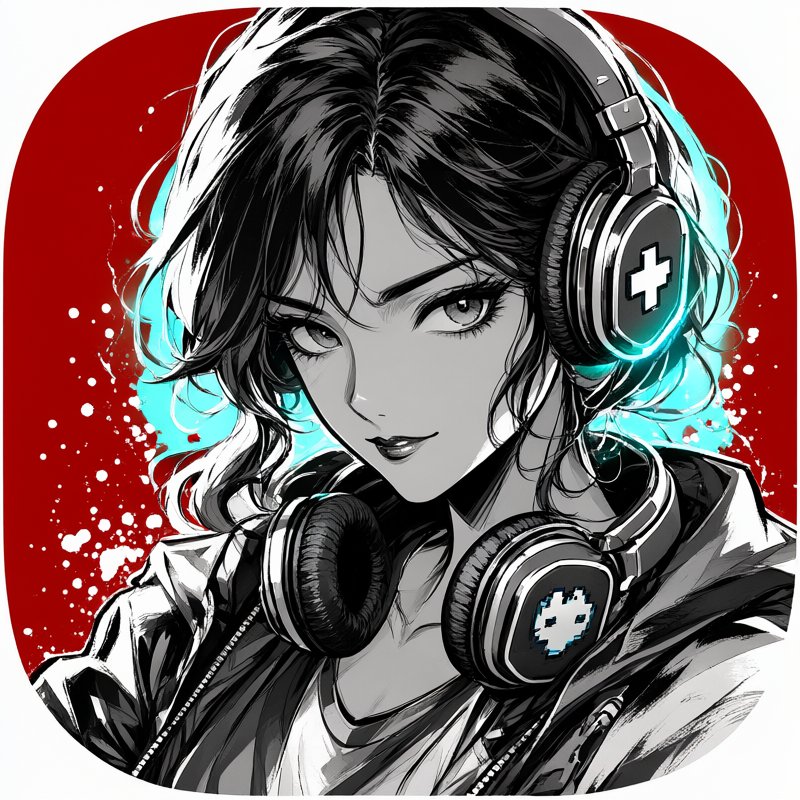
第四张继续往现代走:戴游戏耳机的潮酷女生,耳机上还有个像素十字的标志。赛博感一下就上来了。
后面几张越玩越嗨。先是两个白发女性角色——一个卷毛,双眼直接冒蓝光,像灵能者;一个头发盘起来,领口别着蓝宝石,像贵族小姐。
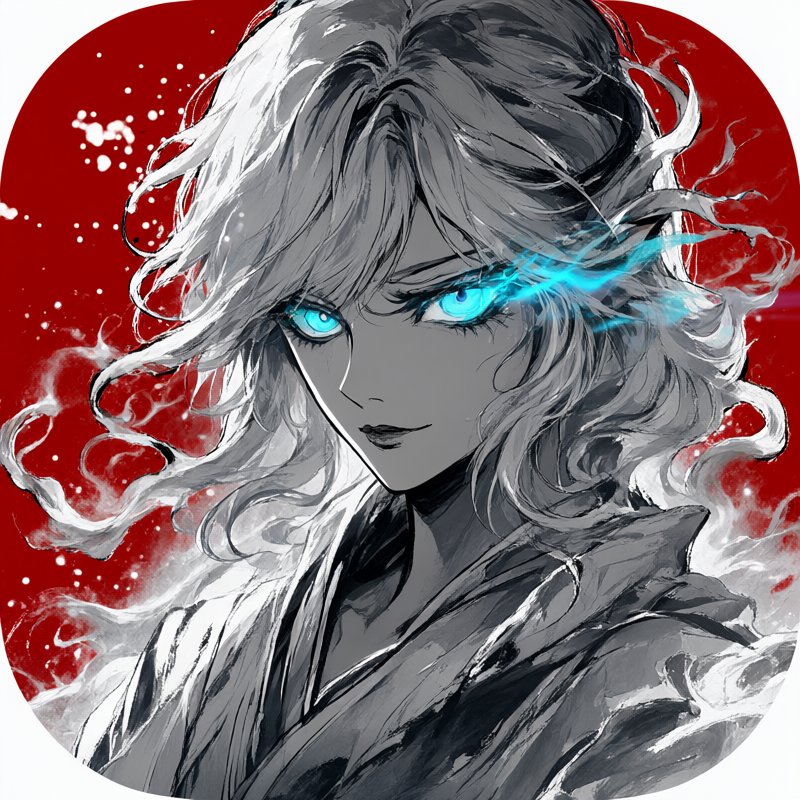
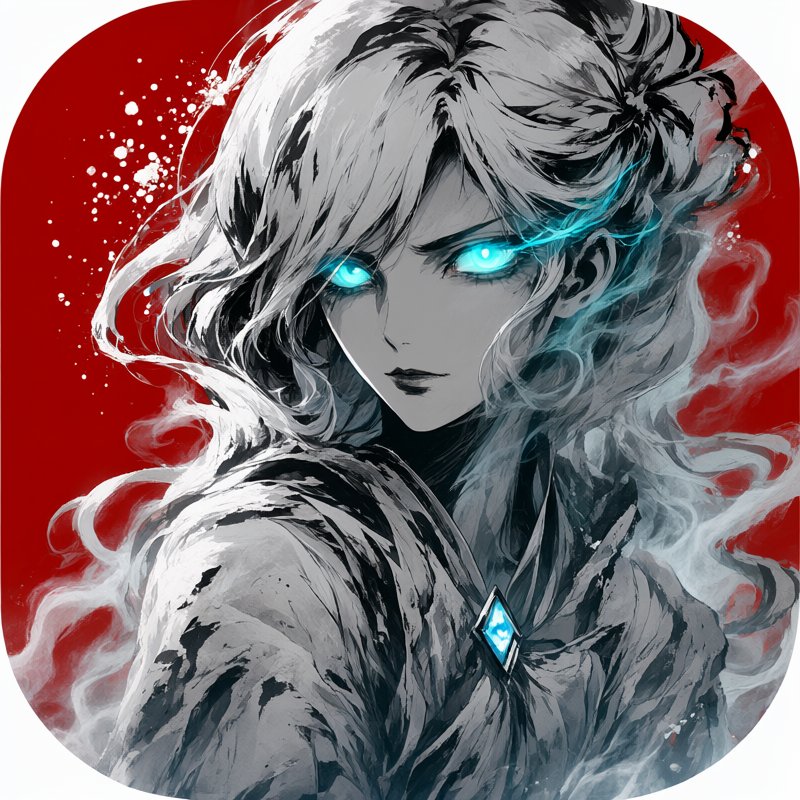
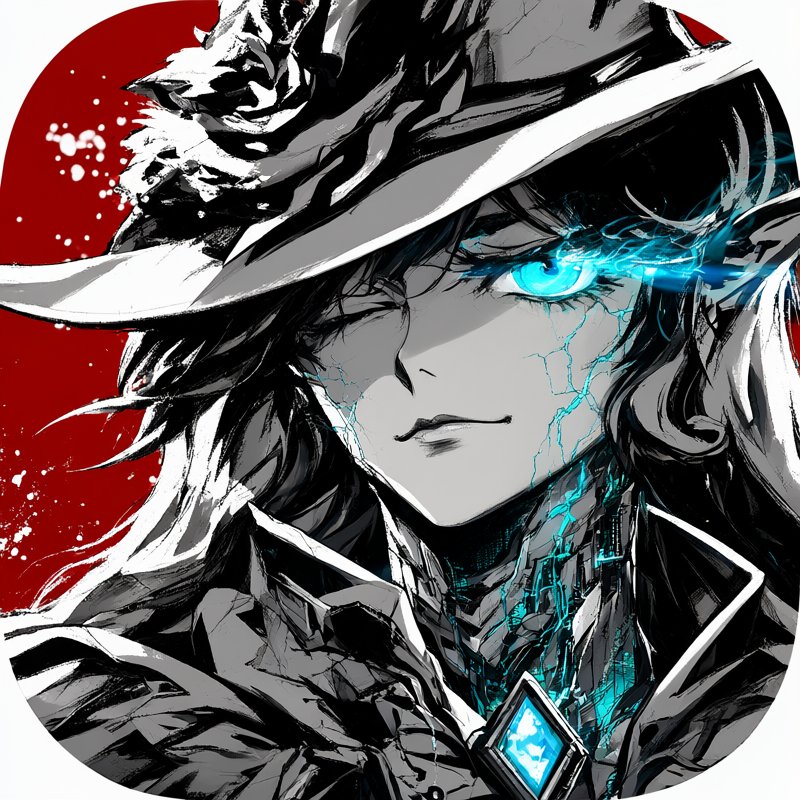
然后是戴宽檐帽的侦探,蓝色的电光裂纹从眼睛蔓延到脖子——那个坏笑太有味道了。
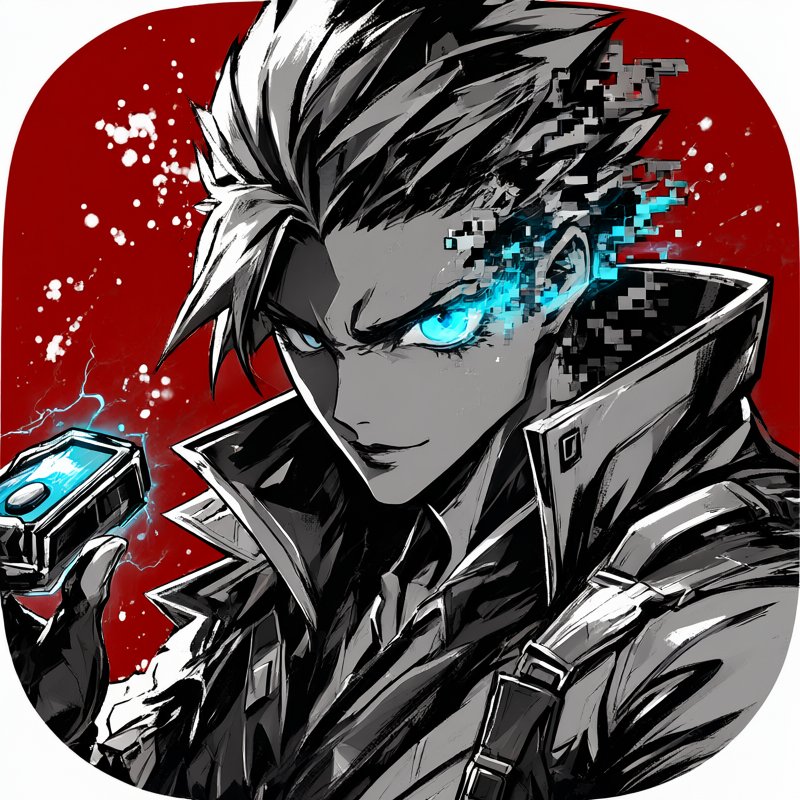
最后一张是赛博男黑客,一只耳朵正在像素化消散——这是全套里我最喜欢的一张,数字幽灵的感觉。
八张图,前后花了大概一个多小时。不是一张张慢慢磨的,是提示词换角色、出图、挑一张满意的、再换下一个角色。画风锁定之后,剩下的就是角色设计的乐趣了。
而且圆角方形这个裁切特别妙——它天然就是 App Icon 的形状。八张图排成一排,像手机桌面上一整页游戏图标,风格高度统一,放到任何独立游戏项目里都直接能用。
四、ComfyUI 工作流详解
上面七张角色图都是本地 ComfyUI 跑出来的。先看简化版流程图,数据走向一目了然:
flowchart LR
    A[UNETLoader<br/>anima-turbo-v1.1] --> B[ModelSamplingAuraFlow<br/>shift=3]
    C[CLIPLoader<br/>Qwen3-4B] --> D[CLIPTextEncode<br/>正面提示词]
    E[CLIPLoader<br/>Qwen3-4B] --> F[CLIPTextEncode<br/>负面提示词]
    B --> G[KSampler<br/>steps=8 cfg=1.0]
    D --> G
    F --> G
    H[EmptySD3LatentImage<br/>1024×1024] --> G
    G --> I[VAEDecode<br/>ae.safetensors]
    I --> J[SaveImage<br/>输出PNG]
再看真实的 ComfyUI 界面全貌——左边是三个模型加载器,中间是两个文本编码和采样参数,右边是解码出图:
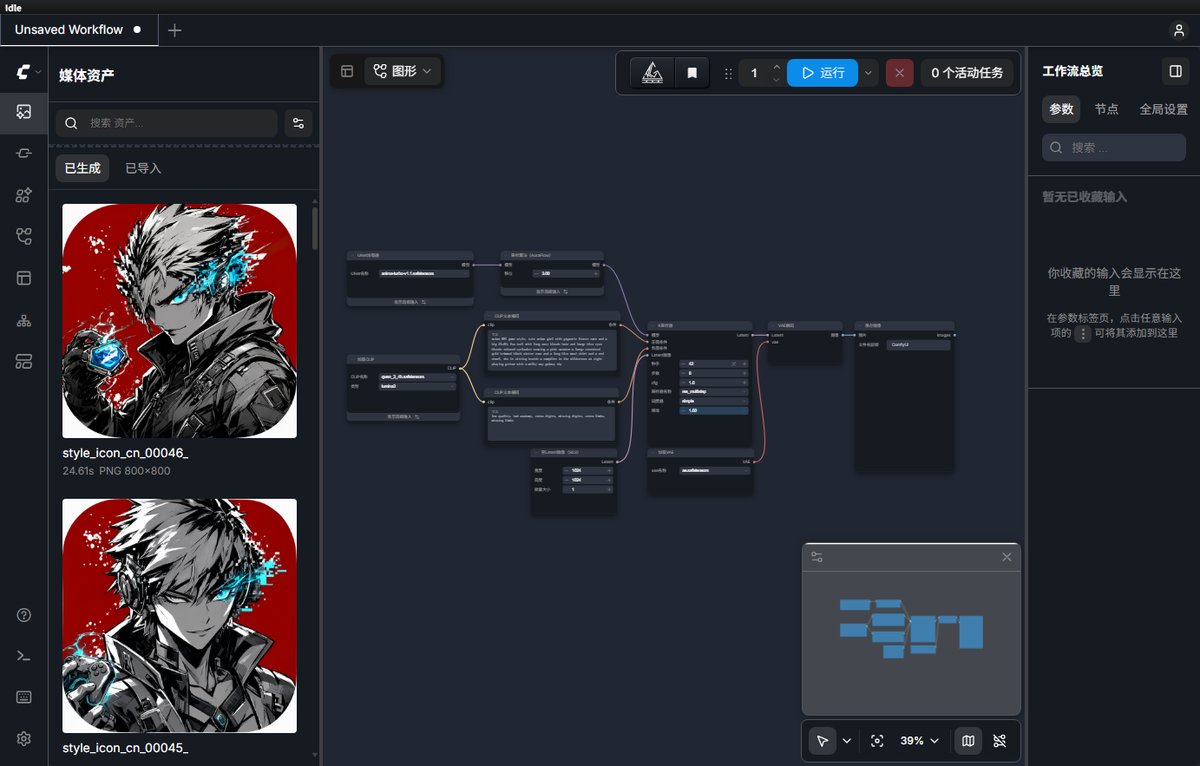
这套配置跟你在网上看到的 SDXL / Flux 教程不太一样,简单说一下:
| 节点 | 配置 | 干嘛的 |
|---|---|---|
| 底模 | anima-turbo-v1.1 | 一个 turbo 蒸馏模型,8 步出一张图 |
| 文本编码器 | Qwen3-4B | 不是传统 CLIP,是用大语言模型读懂你的提示词 |
| 采样 | AuraFlow,shift=3 | 流匹配架构,CFG 直接拉到 1.0 |
| VAE | ae.safetensors | 配套解码器 |
| 尺寸 | 1024×1024 | 方图,图标/头像专用 |
几个有意思的点:
8 步就出图。 传统 Stable Diffusion 要 20-30 步,这个 turbo 模型 8 步就完事。CFG 设成 1.0,意味着 classifier-free guidance 整个关掉了——流匹配模型不需要这一步。快是有代价的(细节不如大模型),但出图标绰绰有余。
文本编码器是 Qwen3-4B。 这点很关键。传统 CLIP 对长提示词、复杂语义的理解很弱,你写"半张脸藏在阴影里,兜帽遮住一只眼睛"它可能就懵了。但 Qwen3-4B 是正经大语言模型,你用大白话描述它都能懂。这就是为什么这套工作流写提示词不用背一堆英文标签。
一张图几秒钟。 turbo 模型 + 1024 分辨率,消费级显卡上几秒一张。你可以一晚上刷几十张,挑满意的留下。这种迭代速度,云端大模型比不了。
五、提示词直接拿走
把这套画风翻译成可以直接用的提示词模板:
正面:
black and white ink illustration, pen and cross-hatching, woodcut printmaking,
high contrast chiaroscuro, dramatic side lighting, half face in shadow,
selective color: only crimson red background and cyan glowing accents,
splash ink dots on background, dark comic art style, rough brush strokes,
rounded square icon composition, [在这里写你的角色]
负面:
colorful, smooth gradient, soft airbrush, photorealistic, pastel, chibi,
low quality, bad anatomy, extra digits, missing limbs
方括号那段换成你的角色就行。举几个例子:
- 老巫师:
elderly white-haired wizard, long beard, stern expression, dark robe - 女刺客:
young hooded female assassin, half face hidden in shadow, glowing cyan eye, holding a poisoned dagger - 赛博黑客男:
young man with spiky hair, cybernetic pixels dissolving near his ear, glowing cyan eyes, holding a glowing device - 电光侦探:
mysterious woman wearing wide-brimmed hat, electric blue cracks spreading across her face and neck, smug expression
关键就两句:selective color 告诉模型"只准两个颜色",woodcut + cross-hatching 把线条质感锁死。加了 rounded square icon composition 就是图标构图,不加就是普通头像。剩下的自由发挥。
六、一套图,怎么喂饱四个平台
八张图出来,事情才刚开始。独立游戏人最赚的不是单张图,是一份素材反复用。
这套东西我打算这么分发:
博客长文——就是你正在看的这篇。从头到尾讲清楚画风怎么拆、工作流怎么搭、提示词怎么写,配全部八张原图。面向跟我一样自己折腾的人,深度优先。
知乎回答——找"AI 绘画有哪些容易出效果的小众画风"这类问题回答。挑四张最有冲击力的图放上去,讲画风拆解,砍掉 ComfyUI 技术细节,末尾一句"完整工作流在我博客"。
小红书图文——做九张图:封面放八张角色拼图,内页拆四层画风教学,最后一张放提示词截图。文案压到三百字以内,标题走"用 AI 画了一套暗黑游戏图标,这个红底太帅了"。
短视频——60 秒。前 3 秒八张图快速切换,中间 20 秒讲三色配方,然后放 ComfyUI 跑图录屏,最后 5 秒"提示词放评论区,自己去试"。
一篇主稿,四个出口,素材全是同一套图。这不是把同一段话复制粘贴四次,是根据每个平台的阅读习惯重新组织——博客讲深,知乎讲巧,小红书讲美,短视频讲快。
七、几个踩过的坑
折腾了一圈,几条实在经验:
先定锚点,再批量复制。 别上来就在本地 ComfyUI 里从零调风格——那是个无底洞。先在云端大模型用自然语言试出满意的第一张,把那张图作为参考喂进本地做图生图,后面全靠它延展。云端负责探路,本地负责量产。
颜色越少越高级。 大多数人 AI 出图是越画越花,恨不得把彩虹都塞进去。反着来——主动限制颜色数量,朱红 + 黑白 + 一点青蓝,画面立刻高级。这个三色配方你记下来,暗黑题材通杀。
圆角方形是个好主意。 一开始没特意要求图标构图,出来发现圆角裁切天然就是 App Icon 比例。一个图身兼两职——游戏上架用是图标,裁掉圆角就是头像,性价比直接翻倍。
图生图比提示词管用十倍。 你说一百句"暗黑漫画风",不如直接扔一张参考图进去。现在的模型对参考图的遵循度已经很高了,风格一致性这件事,一张锚点图顶一万个关键词。
八张图放在这里了,提示词也放在这里了。你要是想凑齐一套十二张角色卡,照着这个配方继续写角色描述就行。下一篇我会把这套东西真的发到四个平台上去,看看每个出口的数据反馈到底怎么样。